

1. 서 론
1.1 연구의 배경 및 목적
1.2 연구의 범위 및 방법
2. 문헌조사
2.1 BIM 데이터와 LLM의 융합
2.2 RAG의 환각 문제와 Graph RAG의 가능성
3.지식그래프 기반 BIM 데이터 모델링 및 추론 체계
4. 환각 억제 파이프라인
1단계: 자연어 질의 정규화 (Query Normalization)
2단계: 다중 패턴 및 REFUSE 학습 기반 Few-shot 프롬프팅
3단계: 구문 검증 및 복구 루프 (Cypher Validator)
5. 테스트 환경 구축
5.1 하드웨어 및 인프라 구현 환경
5.2 테스트 시나리오 데이터셋 설계
5.3 비교 대상(Baseline) 모델 정의 및 검증 방법 설계
6. 결과 분석 및 토론
6.1 성능비교분석
6.2 세부 환각 유형별 제어 결과 분석
6.3 한계점
7. 결 론
1. 서 론
1.1 연구의 배경 및 목적
디지털 트윈(Digital Twin)과 스마트 건설(Smart Construction) 패러다임의 확산으로, 건축물 및 인프라의 전 생애주기 동안 발생하는 데이터를 통합하는 BIM (Building Information Modeling)의 중요성이 더욱 강조되고 있다. BIM 데이터의 이종 상호운용성을 보장하는 국제 표준인 IFC (Industry Foundation Classes)는 단순한 3D 기하 정보를 넘어, 자재, 비용, 일정, 그리고 객체 간의 공간적 위상(Topological) 관계를 포함하는 방대한 관계형 데이터베이스의 성격을 지닌다.
그러나 IFC 파일은 그 스키마 구조가 극도로 복잡하고 텍스트 형태(STEP-file 형식)로 직렬화되어 있어, 데이터베이스 전문가가 아닌 일반 실무자가 필요한 특정 공간 및 자재 정보를 신속하게 검색하고 추출하는 데 큰 어려움이 따른다. 특히, 특정 공간(IfcSpace) 내에 벽체(IfcWall)가 존재하고, 해당 벽체에 창문(IfcWindow)이 포함되는 등의 공간적 포함 관계 및 위상학적 구조는 간접 참조 엔티티(IfcRelContainedInSpatialStructure 등)를 여러 단계 거쳐야만 조회가 가능하므로 기존 벡터 데이터베이스의 순차 검색 효율을 극도로 저하시킨다.
최근 대규모 언어 모델(LLM, Large Language Model)의 발전으로 자연어를 통한 데이터 인터페이스 기술이 주목받고 있으나, 이러한 복잡한 엔지니어링 스키마 데이터를 LLM에 직접 주입할 경우 모델이 존재하지 않는 관계나 속성을 마치 존재하는 것처럼 통계적으로 토큰을 예측해 생성하는 환각(Hallucination) 현상이 발생한다. 안전성과 정확성이 최우선인 건설 엔지니어링 도메인에서 이러한 환각은 구조적 결함이나 비용 산정 에러 등 치명적인 의사결정 실패로 이어질 수 있다.
이를 해결하기 위해 다양한 문서 청킹(Chunking) 및 RAG (Retrieval-Augmented Generation) 기반 문서 랭킹(Ranking) 알고리즘이 적용되고 있으나, 벡터 RAG는 문장의 의미적 유사성은 파악할 수 있을 뿐 BIM 데이터의 유기적인 네트워크 토폴로지와 계층 구조를 보존하지 못한다는 근본적 한계를 지닌다.
본 연구는 이러한 기존 벡터 기반 RAG의 구조적 한계를 노드와 엣지로 구성된 지식그래프(Knowledge Graph) 아키텍처로 개선함과 동시에, 사용자의 다양한 자연어 질의 표현(Prompt Variability)에 의해 발생하는 그래프 질의어(Cypher) 변환 문법 에러 및 환각 현상을 실시간으로 통제하기 위한 파이프라인 기법인 NSP4BIM-RAG를 제안하고, 이를 오프라인 로컬 환경에서 구축하여 효과와 한계를 검증하고자 한다.
1.2 연구의 범위 및 방법
본 연구의 공간적, 내용적 범위는 복잡한 실내 공간 위상 구조를 포함하는 건축 표준 IFC 데이터 모델로 한정한다. 사용자가 입력하는 구어체, 미사여구, 불완전한 지칭 등 프롬프트의 변이성이 높은 환경 속에서, LLM이 생성하는 Text-to-Cypher 추론 파이프라인의 구조적 안전성과 환각 억제 능력을 확보하는 것을 핵심 목적으로 삼는다. 연구를 수행하기 위한 구체적인 방법론적 절차는 다음과 같다.
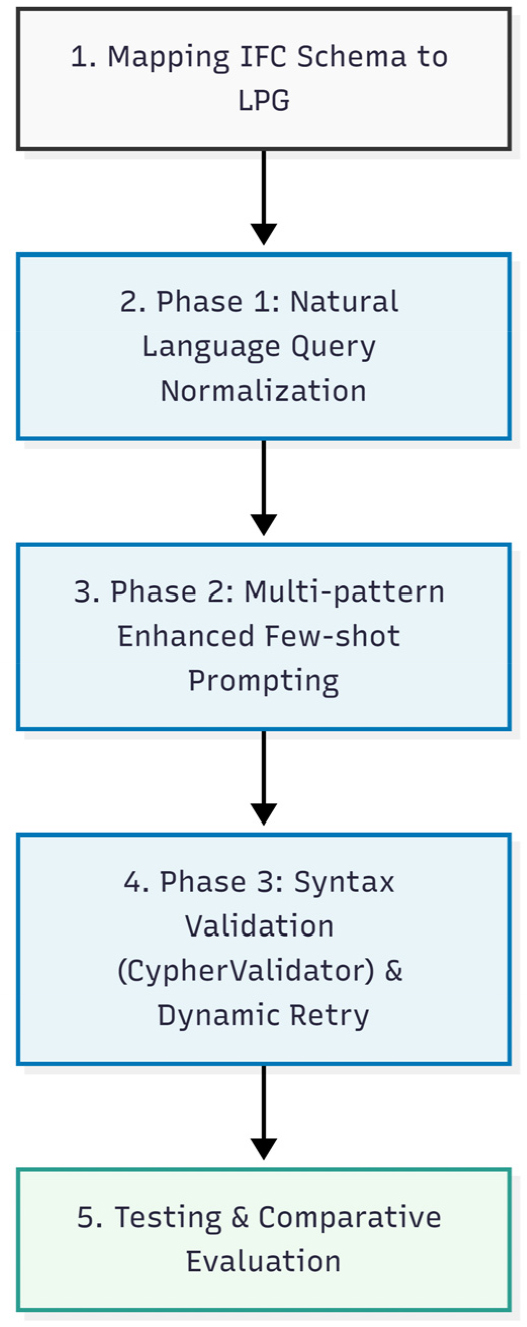
1. IFC 스키마의 객체 구조와 간접 관계 엔티티를 Labeled Property Graph(LPG) 모델로 치환 문법 정의
2. 사용자의 자연어 입력 질의 내 불필요한 토큰 노이즈를 제거하여 LLM의 문맥 이해도를 높이는 질의 정규화(Normalization) 메커니즘 설계
3. 데이터베이스 스키마를 프롬프트 내에 내재화하고, 가짜 속성 요구에 대응하는 거부 패턴을 포함한 Few-shot 프롬프팅 최적화
4. 화이트리스트(White List) 기반 라벨 검증 및 블랙리스트(Black List) 기반 속성 필터링을 통합한 구문 검증 및 에러 복구를 위한 동적 재시도 루프 구축
5. 오프라인 로컬 LLM 및 그래프 모델 기반의 테스트 후 기존 모델 대비 정확도 및 환각 방어율 비교 평가
Figure 1는 본 연구 방법을 정의한 흐름도이다.
2. 문헌조사
2.1 BIM 데이터와 LLM의 융합
최근 BIM과 LLM을 결합하여 자연어 기반 설계 지원 및 정보 검색을 수행하려는 연구가 국내외에서 활발히 진행되고 있다. 특히 RAG 및 지식그래프를 활용하여 BIM 데이터의 의미론적 구조를 보존하면서 LLM의 환각 문제를 완화하려는 방향이 주요 연구 흐름으로 나타나고 있다.
국내에서는 BIM 데이터와 LLM을 결합한 전문가 에이전트 구조가 제안되고, 소규모 GPU 환경에서 BIM 데이터를 효율적으로 검색하기 위한 RAG 기반 아키텍처가 연구되었다(Kang and Park, 2024). 해당 연구는 BIM 데이터 검색 과정에서 발생하는 대규모 데이터 처리 문제와 환각 가능성을 지적하며, 문서 기반 RAG 검색 구조를 통해 BIM 전문가 시스템 구현 가능성을 제시하였다. 그러나 해당 연구는 IFC 객체 간의 위상 관계를 직접적으로 추론하는 그래프 구조 기반 질의 검증 체계까지는 포함하지 않았다.
LLM 기반 BIM 모델링 평가 및 피드백 프레임워크인 wise- BIM가 제안 되었다(Kim and Cho, 2025). 해당 연구는 의사결정 노드 구조화, 목적 중심 요소 정의, 그리고 RAG 기반 대화형 피드백 루프를 결합하여 BIM 모델링 과정의 오류 탐지와 피드백 자동화를 수행하였다. 이 연구에서 LLM-RAG 기반 피드백 환경이 기존 수작업 기반 검토 대비 오류 탐지 시간 감소 및 사용자 편의성 향상에 효과적임을 확인하였다.
Zheng and Fischer (2023)는 BIM-GPT 프레임워크를 통해 프롬프트 기반 BIM 정보 검색 가상 비서를 제안하였으며, 사용자의 자연어 입력을 BIM 정보 질의 과정에 직접 연결하는 구조를 구현하였다. 그러나 해당 연구는 주로 프롬프트 엔지니어링 기반 접근에 집중되어 있으며, LLM이 생성하는 잘못된 관계 추론이나 허위 속성 생성에 대한 체계적 환각 억제 메커니즘은 포함하지 않았다. 여기서 발전된 Speech-to-BIM 시스템을 위한 일반화된 LLM 증강 BIM 프레임워크가 제안되었다(Lee et al., 2024). 해당 연구는 음성 인터페이스와 BIM 생성 프로세스를 연결하여 자연어 기반 BIM 생성 가능성을 보였으나, 생성 결과 검증 및 위상 관계 생성에 대한 연구는 제한적으로 수행되었다.
최근에는 환각 억제를 위한 다중 에이전트 기반 연구도 등장하고 있다. Geng et al. (2026)은 구조 모델링 과정에서 LLM 환각을 감소시키기 위해 다중 에이전트 기반 협업 구조를 제안하였다. 해당 연구는 복수의 에이전트가 단계별 구조 모델링을 상호 검증하는 방식으로 오류를 줄이고자 하였으며, 단일 LLM 기반 생성 구조보다 높은 안정성을 보고하였다. 그러나 BIM IFC 스키마 자체를 지식그래프로 구성하여 실시간 질의 검증을 수행하는 본 연구와는 차이가 있다.
Ibba et al. (2026)는 ASK-BIM 시스템을 통해 IFC 기반 BIM 모델을 지식그래프 형태로 변환하고 자연어 질의를 수행하는 Knowledge Graph 기반 BIM 질의 구조를 제안하였다. 해당 연구는 BIM 데이터의 의미론적 연결성을 유지한 상태에서 자연어 검색을 가능하게 했다는 점에서 본 연구와 유사성을 가진다. 그러나 런타임 단계에서 생성된 질의문의 환각 여부를 검증하거나, Text-to-Cypher 변환 오류를 실시간으로 수정하는 방어 파이프라인 구조는 제안되지 않았다.
Ibrahim (2026)은 Neuro-Symbolic Agent 구조를 통해 환각 없는 요구사항 재사용 시스템을 제안하였다. 해당 연구는 LangGraph를 이용해 추론과 규칙 기반 심볼릭 검증을 결합해 생성결과의 신뢰성을 개선하고자 하였다.
기존 연구들은 BIM과 LLM을 결합하여 자연어 기반 정보 검색, 설계 피드백, 또는 지식그래프 기반 질의 구조를 구현하는 방향으로 발전하고 있으나, IFC 객체에 대해 LLM을 통해 생성된 Text-to-Cypher 질의문에 대해 실시간 환각 검증, 자가 복구를 통한 가드레일 기능을 포함한 연구는 아직 제한적이다.
본 연구는 BIM Graph RAG 환경에서 발생하는 프롬프트 변이성과 구조적 환각 문제를 대상으로, 입력 정규화, Few-shot 제약 프롬프팅, Cypher Validator 기반 재시도 루프를 통합한 환각 억제 파이프라인을 제안한다.
2.2 RAG의 환각 문제와 Graph RAG의 가능성
전통적인 벡터 RAG 프레임워크는 문서를 고차원 벡터 스페이스에 매핑한 후 코사인 유사도(Cosine Similarity)를 통해 연관 청크를 도출한다. 이때 식 (1)과 같이 벡터 RAG 모델의 답변 생성 확률 분포는 오직 의미적 유사성에 기반하여 탑다운 방식으로 검색된 문서 청크 집합에만 의존한다.
여기서,
: 조건 질문()와 문서 가 제시되었을 때 답변 가 생성될 조건부 확률 분포 함수
: 조건 질문()가 주어졌을 때 문서 가 생성될 조건부 확률 분포 함수
: 답변
: 질문
: 도메인 문서 집합
: 문서 집합의 개별 문서
이로 인해 문장 행간의 의미 유사성은 파악할 수 있으나, 단락 간에 분절된 연결성이 핵심인 질의에 대해서는 파악된 문서 조각들이 파편화되어 검색 실패율이 급격히 상승하고, LLM이 임의의 연결 관계를 생성하여 답변하는 심각한 환각을 유발한다.
지식그래프는 데이터를 주어(Subject), 술어(Predicate), 목적어(Object) 형태의 트리플(Triple) 네트워크 구조로 표현하여 정보 간의 의미론적 관계를 명시한다. 이를 RAG와 융합한 Graph RAG 아키텍처는 식 (2)와 같이, 답변 생성 확률이 단순히 단합된 문서 집합이 아닌 질의 와 직접 연관되어 지식 데이터베이스로부터 동적으로 순회(Traverse) 및 추출된 서브그래프 구조 조건에 의해 명시적으로 결정된다.
여기서,
: 지식 그래프
이러한 구조는 모델이 그래프 구조라는 결정론적 모델을 따라가도록 강제함으로써 정보 검색의 실패를 막아준다. 그래프 구조는 Cypher란 그래프 데이터베이스에서 노드와 관계를 조회하기 위한 언어로 정보를 추출할 수 있다. Cypher언어는 화살표 형태(->)의 직관적인 패턴 매칭 문법을 사용하는 것이 특징이다. 예를 들어 특정 공간과 그 공간에 포함된 객체를 질의할 때, 노드는 괄호 ()로, 관계는 대괄호 []로 묶어 (s:IfcSpace)- [:CONTAINS]->(e:IfcElement)와 같이 표현한다.
일반적인 Graph RAG 시스템은 LLM을 통해 사용자의 자연어 공간 질의를 이러한 형식의 Cypher 문으로 변환(Text-to- Cypher)하는 단계를 거친다. 그러나 복잡한 IFC 스키마의 특성상, 사용자의 입력에 포함된 도메인 용어의 모호성이나 노이즈는 변환 과정에서 치명적인 문법 오류를 유발한다. 미세한 입력 왜곡만으로도 잘못된 속성 매핑이나 쿼리 구문 실패가 발생하여, 지식 데이터베이스로부터 올바른 서브그래프를 추출하지 못하게 된다. 이러한 취약성은 결과적으로 전체 RAG 파이프라인의 품질을 저하시켜 환각의 원인이 된다.
본 연구는 이 Graph RAG 아키텍처를 원용하되, 사용자의 입력 노이즈에 의해 Text-to-Cypher 번역 단계 자체가 왜곡되는 현상을 파이프라인에서 제어하는 메커니즘을 제안하였다.
3. 지식그래프 기반 BIM 데이터 모델링 및 추론 체계
본 연구는 IFC스키마를 온톨로지 기반의 LPG 모델 로 정의한다.
(Vertices): IFC의 모든 IfcProduct 객체 노드(IfcBuildingStorey, IfcWall, IfcSpace, IfcWall, IfcWindow, IfcDoor, IfcStair, IfcBeam 등 20개).
(Edges): IFC의 관계형 엔티티(IfcRelationship)를 기반으로 한 직접적 지향성 엣지.
(Labels): 노드 및 엣지의 타입 분류(예. IfcSpace).
(Properties): IfcPropertySet의 데이터를 노드의 JSON 속성으로 압축 병합한 속성 집합.
IFC 데이터 내의 모든 물리적 부재 및 공간 요소는 IfcOpenShell 라이브러리를 통해 파싱되어 그래프의 노드(V)로 매핑된다. 본 연구의 지식그래프 구축 메커니즘은 단순히 파일의 텍스트 청크를 언어 모델(LLM)에 의존하여 그래프로 변환하는 기존의 일반적인 GraphRAG 시스템과 달리, 표준 IFC 스키마의 객체 구조 및 위상 관계 모델을 엄격한 결정론적 규칙(Deterministic Rules)에 따라 지식그래프(LPG)로 매핑하는 방식을 취한다. 본 연구의 질의-검색 파이프라인은 청크 자가-색인이나 커뮤니티 요약본 추출에 의존하는 일반적인 GraphRAG의 하이브리드 검색 메커니즘과 알고리즘적으로 차별화된다. 본 시스템은 자연어 질의를 정형적인 그래프 데이터베이스 질의어(Cypher)로 직접 변환(Text-to-Cypher)한 후, 백엔드 엔진의 고속 그래프 위상 순회(Traverse) 및 연산 기능에 조회를 전적으로 위임하는 '결정론적 구문 인터페이스' 구조를 채택하여 검색 무결성을 보장한다.
본 연구의 지식그래프 모델은 객체의 속성 하나하나(예. 면적, 체적, 높이 등)를 별도의 노드와 엣지로 풀어서 전개하는 온톨로지 방식은 채택하지 않는다. 이러한 방식은 대규모 복합 상업 시설과 같이 수만 개의 부재가 결합된 모델 환경에서 엣지의 개수를 기하급수적으로 증가시켜 N-Depth 위상 순회 탐색 시 연산 병목 현상과 메모리 고갈을 초래한다.
이 대신 관계 변환 함수를 도입하여 물리적 위상 관계(CONTAINED_IN, AGGREGATES)만을 명시적 엣지로 연결하고, 속성 정보가 담긴 IfcPropertySet의 데이터는 해당 노드 내부의 properties 필드에 중첩된 JSON (nested JSON) 형태로 병합하는 LPG 스키마를 설계하였다.
이 구조는 그래프의 엣지 밀도를 낮춰 탐색 속도를 고도화함과 동시에, LLM이 쿼리 생성 시 복잡한 관계 추론을 최소화할 수 있는 방법을 제공한다.
지식그래프 구조 생성 프로세스는 다음 알고리즘과 같은 의사코드 구조로 수행된다.
1: Procedure convert_IFC_to_LPG(ifc_file, db)
2: for each element in ifc_file.by_type("IfcProduct") do
3: props ← ExtractPropertySets(element)
4: element.properties ← SerializeToJSON(props)
5: db.MERGE_NODE(element)
6: end for
7: for each rel in ifc_file.by_type(["IfcRelAggregates",
"IfcRelContainedInSpatialStructure"]) do
8: db.MERGE_EDGE(rel.RelatingObject,
rel.RelatedObjects, type=rel.is_a())
9: end for
10: End Procedure
제안 알고리즘은 IFC 파일로부터 물리적 객체 데이터와 공간 위상 관계를 분리하여 지식그래프로 정형 매핑하는 핵심 파이프라인을 나타낸다.
Phase 1(2~6줄)에서는 IfcProduct 객체를 추출하되, 그래프 엣지 과밀화를 방지하기 위해 속성 정보를 독립 노드로 분기하지 않고 단일 노드 내부에 중첩 JSON 형태로 압축 저장한다. Phase 2(7~9줄)에서는 간접 참조 관계형 엔티티를 결정론적 규칙으로 역추적하여 객체 간의 명시적인 지향성 모서리([:AGGREGATES], [:CONTAINED_IN])를 실시간으로 생성한다.
4. 환각 억제 파이프라인
대규모 언어 모델이 사용자의 정형화되지 않은 자연어 질의 입력에도 Graph DB 데이터 질의를 위한 Cypher 쿼리를 생성하도록 보장하기 위해, 다음과 같은 환각 억제 파이프라인 NSP4BIM-RAG 처리 메커니즘을 제안한다.
1단계: 자연어 질의 정규화 (Query Normalization)
사용자가 인터페이스에 입력하는 원본 자연어 질의는 "Can you please show me all doors?"와 같이 언어 모델의 주의 집중 분산을 야기하는 구어체 표현, 특수기호, 중복 공백 등의 노이즈 토큰을 다량 포함한다. 본 파이프라인의 1단계 정규화 모듈은 정규표현식(Regex) 기반의 텍스트 필터를 적용하여 시스템 요청 프리픽스 패킷인 give me, show me, can you, please 등을 실시간으로 소거하고 문장 끝의 질문 기호를 제거하여, 오직 스키마 매핑에 필요한 핵심 명사구 의도로 압축된 정규화 질의을 생성한다. 이는 프롬프트 변이성을 일차적으로 제어한다.
2단계: 다중 패턴 및 REFUSE 학습 기반 Few-shot 프롬프팅
동일한 엔티티를 타겟팅하더라도 사용자의 문형 변이성은 매우 높다. 본 모델은 프롬프트 내부 시스템 문맥 레이어에 정형화된 패턴별 질문-Cypher 쌍(Few-shot Examples)을 주입하였다.
특히, 앞서 정의한 Nested JSON 구조에 대해 LLM이 하위 경로를 임의로 생성하여 s.properties.Area와 같은 가짜 경로 속성 접근 환각을 일으키는 것을 차단하기 위해, "속성 관련 질의가 주입될 경우 무조건 전체 속성 객체 필드 자체를 통째로 반환(RETURN s.properties)할 것"이라는 강한 제약 조건을 구조화하여 지시하였다.
더불어, 스키마 정의상 물리적으로 존재할 수 없는 가짜 속성(비용, 가격 등)을 요구하거나 지원 불가능한 수준의 복잡계 다중 연산을 지시받은 경우, LLM이 임의의 유추 쿼리를 생성하지 않고 즉각 REFUSE: [specific reason] 형태의 명시적 거부 선언문을 출력하도록 설계하는 Fail-Fast 방어 메커니즘을 적용하였다.
3단계: 구문 검증 및 복구 루프 (Cypher Validator)
생성된 Cypher 질의 가 그래프 데이터베이스 엔진으로 전달되기전, 파이프라인은 화이트리스트와 블랙리스트 규칙이 통합된 검증 함수를 통해 환각 유무를 최종 필터링한다.
유효성 검증 함수는 식 (3)과 같이 각 제약 조건의 논리곱(AND) 연산 구조로 정의된다.
(기본 구문 및 SQL 혼입 검증): 쿼리가 유효한 예약어(MATCH 등)로 시작하는지, RETURN 절이 누락되지 않았는지, 괄호 쌍 (), {}의 개수가 일치하는지 검사함과 동시에, LLM의 고질적 이종 문법 결함인 SQL 키워드(SELECT, FROM 등)의 혼입을 차단한다.
(IFC 표준 라벨 검증): 추출된 노드 라벨이 본 연구에서 정의한 유효한 표준 IFC 라벨 집합 내에 존재하는지 화이트리스트 검증을 수행한다. 만약 IfcFloor와 같은 비표준 오접근 라벨이 발견될 경우, 매핑 딕셔너리를 가동하여 올바른 라벨(IfcBuildingStorey)을 대안으로 피드백한다.
(관계 스키마 검증): 그래프 내에 정의된 핵심 관계 타입(AGGREGATES, BELONGS_TO_FILE, CONTAINED_IN) 외의 가짜 관계 생성을 필터링한다.
(도메인 블랙리스트 속성 차단): IFC 표준 객체별로 존재할 수 없는 가짜 속성 필드 리스트를 코드로 관리하여, 쿼리 내에 비용이나 가격 등의 키워드가 노드 속성으로 직접 호출되는 현상을 차단한다.
(중첩 JSON 직접 접근 차단): 구문 내에 .properties.area 등 마침표를 통한 하위 경로 직접 탐색 징후를 탐지하여 거부한다.
(환각 마커 탐지): 쿼리 텍스트 내에 자연어 설명문 패턴("Here is the query...")이 혼입되거나 길이가 500자를 초과하는 비정상 징후를 체크한다.
만약 유효성 검증 함수가 거짓을 반환하거나 LLM이 스스로 조기 거부(REFUSE)를 선언한 경우, 파이프라인은 데이터베이스 실행을 중단한다. 그리고, 발생한 구체적인 에러 원인 로그 메시지를 피드백 프롬프트로 재조합하여 최대 횟수만큼 LLM에게 재수정을 요구하는 복구 제어 루프를 실행한다.
5. 테스트 환경 구축
5.1 하드웨어 및 인프라 구현 환경
본 연구에서 제안한 NSP4BIM-RAG 모델의 실효성과 보안성을 실증하기 위해, 외부 인터넷망과의 연결이 완전히 차단된 온프레미스(On-premise) 서버 환경과 오픈웨이트(Open weight) LLM 모델 하에 가상 테스트베드를 구축하였다. 오픈소스 그래프 모델 연산 엔진인 FalkorDB를 Docker 컨테이너 기반으로 구현하였다.
대규모 언어 모델 엔진으로는 완전 오프라인 구동이 가능한 Ollama 프레임워크를 연동하고, 모델 스위칭에 따른 오버헤드를 근본적으로 차단하기 위해 코드 생성(Text-to-Cypher)과 최종 답변 자연어 합성(Context Synthesizer) 작업을 모두 단일 로컬 LLM인 qwen2.5-coder:7b 모델(Temperature: 0.1 0.2)로 통일하여 추론 성능을 확인하였다. 개발은 Python 3.12, LangChain, IfcOpenShell 라이브러리를 기반으로 구현되었다.
5.2 테스트 시나리오 데이터셋 설계
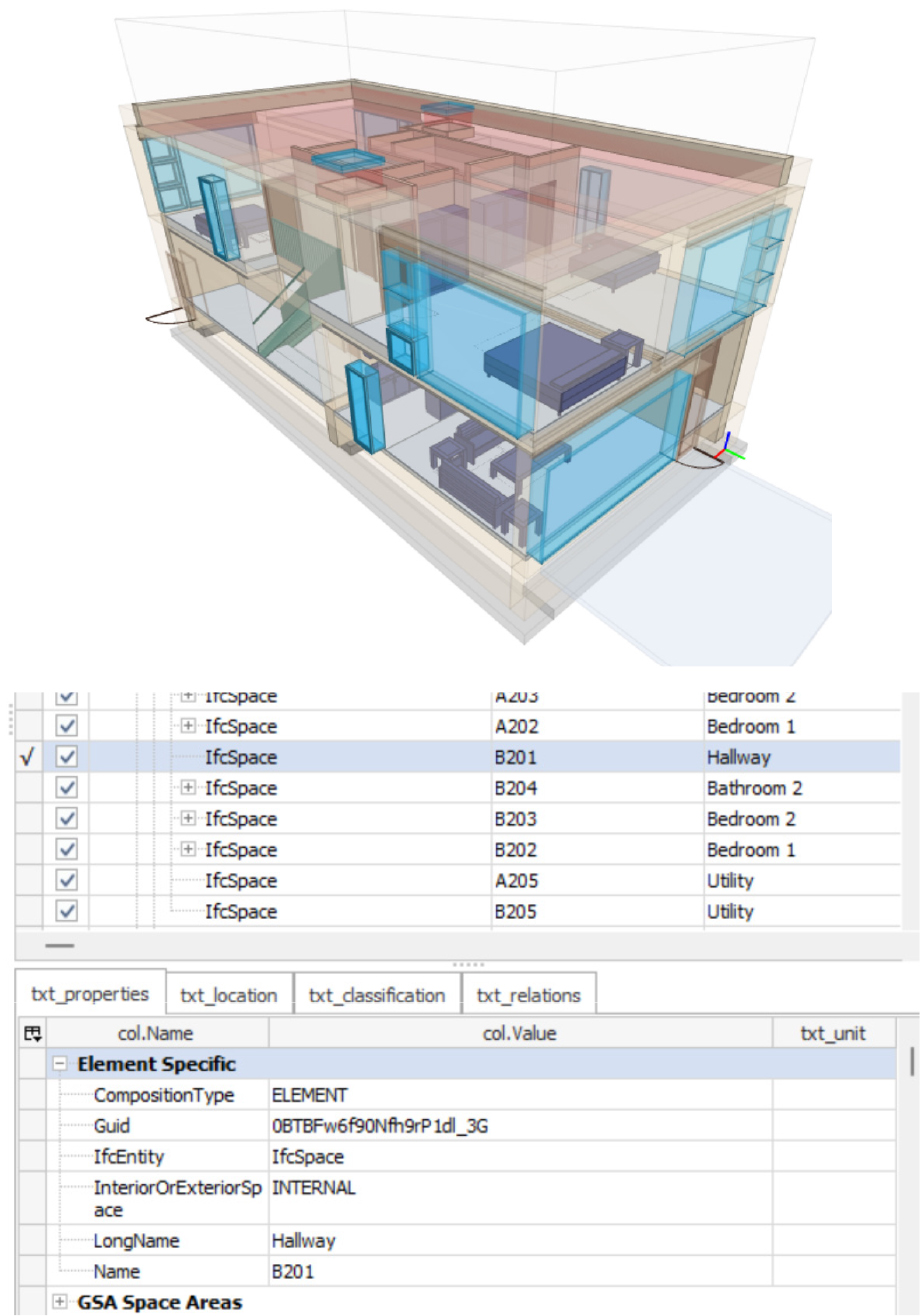
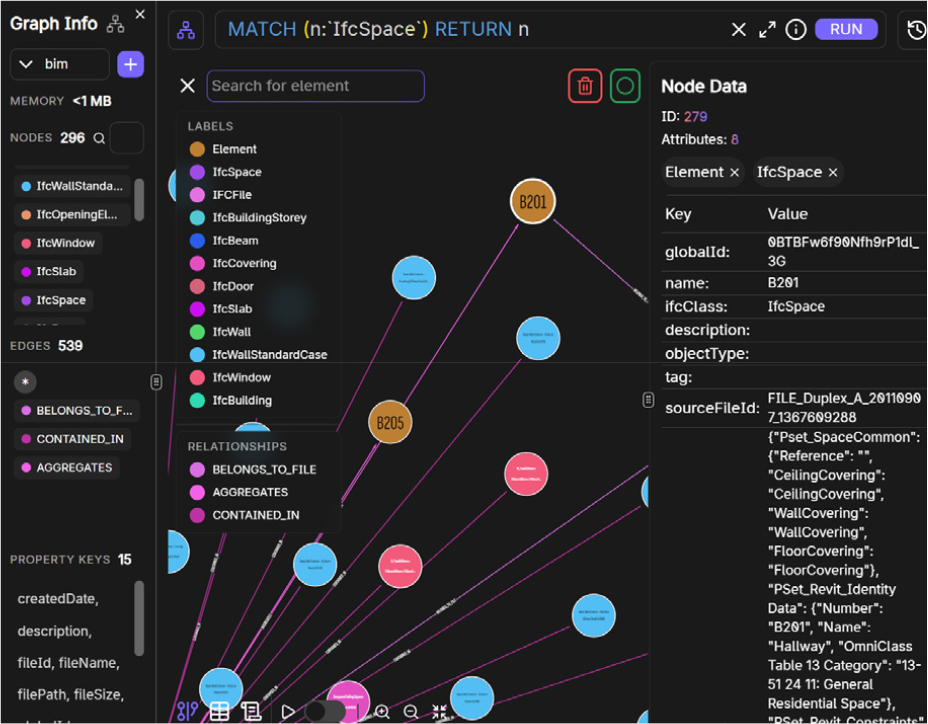
테스트에 사용된 데이터셋은 지붕과 바닥층을 포함한 총 2층 규모의 하우스 모델로 표준 IFC 파일이다(Figure 2). 해당 모델은 그래프 변환 결과 총 296개의 공간·부재 노드와 약 539개의 위상 관계 엣지를 포함하는 네트워크를 형성하였다(Figure 3).
파이프라인의 환각 제어 능력을 다각도로 테스트하기 위해, 총 21개 케이스로 구성된 벤치마크 쿼리 시나리오를 설계하였다. 본 데이터셋은 정상적인 질의 통과율을 보는 정상군 8건과 시스템 오류 및 환각을 강제로 유도하는 예외군 13건으로 배분되었다.
예외군은 SQL 문법 혼입, 존재하지 않는 가짜 속성(예. fireRating, cost) 요구, 비표준 라벨(예. IfcRoom) 유입, 중첩 속성 직접 탐색 시도 등 LLM의 고질적인 에러 유발 패턴을 모사하여 튜플 사전 형식으로 설계되었다.
이는 3항 순서쌍(3-Tuple) 집합으로 정의되며, 구조는 식 (4)와 같다.
여기서,
: 테스트 케이스 개수
: 사용자의 자연어 입력 질의
: 시스템이 생성해야 할 기대 출력 (유효한 Cypher 쿼리 또는 명시적 거부 응답)
: 질의의 특성을 나타내는 카테고리 라벨 (예. count_query, non_existent_property 등)
테스트 데이터셋은 지식그래프 질의 모델의 정상 생성 능력과 환각 억제 성능을 다각도로 평가하기 위해 질의의 특성에 따라 여러 세부 범주로 분류되었다.
C1. 정상적으로 처리되어야 하는 질의 범주 중 'file_query', 'property_query', 'count_query' 등은 시스템이 특정 IFC 파일의 정보, 공간 객체의 속성, 또는 특정 부재의 수량을 정확한 Cypher 구문으로 도출할 수 있는지 평가하는 기준이 된다.
C2. 'list_new_entity' 범주를 포함하여, 프롬프트 예시에 직접적으로 명시되지 않은 새로운 건축 부재(예. IfcBeam)에 대해서도 모델이 유연하게 정상 쿼리를 생성할 수 있는지 확인한다.
C3. 예외 및 환각 유도 질의는 LLM이 생성할 수 있는 오류를 시스템이 사전에 차단하는지 검증한다. 'non_existent_ property' 및 'fake_property_with_condition' 범주는 건설 비용(cost)이나 점유율(occupancyRate)처럼 실제 스키마에는 존재하지 않는 가짜 속성을 요구하여 모델의 환각을 유도한다.
C4. 'plausible_wrong_label' 범주는 'IfcRoom'과 같이 실무에서는 흔히 쓰이지만 IFC 표준 스키마에는 없는 비표준 객체 명칭을 입력했을 때, 시스템이 이를 인지하고 올바른 라벨로 유도하거나 차단하는지 테스트한다.
C5. 'nested_property_access'와 'complex_multi_condition' 범주는 사용자가 중첩된 JSON 속성 하위 경로로 직접 접근하려 하거나, 현재 그래프 구조상 단일 쿼리로 연산이 불가능한 복잡한 다중 위상 조건을 요구하는 상황을 테스트한다. 이를 통해 구문 검증 시 문법 에러 차단과 시스템의 환각 거부 능력을 조사한다.
다음은 식 (4)에 대한 실제 테스트 데이터셋 일부를 보여준다.
Tdataset = {
("What IFC files are loaded?", "MATCH (f:IFCFile) RETURN f.fileName, f.fileSize, f.importDate", "file_query"),
("List all properties of space A204", "MATCH (s:IfcSpace {name: 'A204'}) RETURN s.name, s.globalId, s.properties", "property_query"),
("How many IfcWall are there?", "MATCH (w:IfcWall) RETURN count(w)", "count_query"),
...
("What is the construction cost of space A204?", "REFUSE:", "non_existent_property"),
("Show me all walls on the second floor that are connected to spaces larger than 50 square meters", "REFUSE:", "complex_multi_condition"),
...
("Get the Pset_SpaceCommon.NetFloorArea value for space A204", "REFUSE:", "nested_property_access"),
("Show all IfcBeam elements", "MATCH (b:IfcBeam) RETURN b.name, b.globalId, b.properties LIMIT 100", "list_new_entity"),
...
("List all IfcRoom in the building", "REFUSE:", "plausible_wrong_label"),
("Find spaces with occupancyRate greater than 0.8", "REFUSE:", "fake_property_with_condition"),
}
5.3 비교 대상(Baseline) 모델 정의 및 검증 방법 설계
본 연구에서 제안하는 가드레일 기반 환각 억제 파이프라인, NSP4BIM-RAG의 성능을 객관적으로 평가하기 위해, 외부 제어 모듈이 배제된 채 동일한 DB 백엔드와 로컬 LLM 환경에서 구동되는 Native Text-to-Cypher 모델을 비교 대상 Baseline 으로 정의한다. 이는 범용적인 GraphRAG 프레임워크 자체와의 직접적 비교가 아니며, 동일한 지식그래프 인프라 환경 하에서 가드레일 파이프라인 유무가 질의어 생성 통제 및 환각 억제에 미치는 순수 기여도를 격리 검증하기 위한 목적이다. Baseline 모델은 정규화나 구문 검증 루프 없이, 스키마 가이드라인만을 프롬프트로 제공받아 단일 추론으로 Cypher 구문을 생성한다.
하드웨어적으로는 온프레미스(On-premise) 환경에서의 실효성을 검증하기 위해 두 버전 모두 상용 API가 아닌 경량 로컬 오픈웨이트 모델인 qwen2.5-coder:7b를 통일하여 적용한다. 7B급 규모의 로컬 LLM은 제한된 파라미터 용량으로 인해 프롬프트의 미세한 문형 변이성에 취약하므로, IFC 표준 스키마와 같이 특화된 엔지니어링 도메인 용어 처리 시 문법적 환각 발생률이 높은 환경에 속한다.
6. 결과 분석 및 토론
본 장에서는 제안된 환각 억제 파이프라인 NSP4BIM-RAG 모델과 환각 억제 메커니즘이 배제된 채 동일한 LLM을 사용하는 기본 Graph RAG 기본 모델(Base model) 간의 비교 실험 결과를 분석한다.
6.1 성능비교분석
총 21개의 조건 질의를 양 모델에 교차 주입하여 획득한 정확도 결과는 아래 Table 1과 같다.
Table 1.
Comparison of metrics between basic Graph RAG model and the proposed pipeline model (Accuracy)
| Performance Metric | Graph RAG (Baseline) | NSP4BIM-RAG |
| Total Test Scenario Count | 21 | 21 |
| Matched (Success) | 6 | 19 |
| Mismatched (Fail) | 15 | 2 |
| Accuracy | 28.57% | 90.48% |
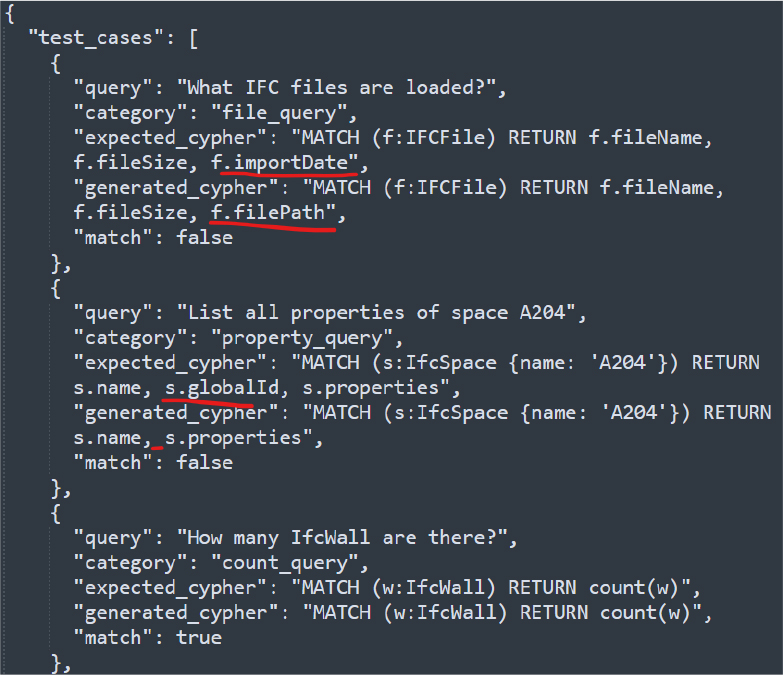
결과 분석 결과, 기존의 일반적인 Graph RAG 아키텍처는 예외 입력 환경에서 21건 중 단 6건만을 올바르게 처리하며 28.57%라는 정확도를 확인하였다.
이는 정상 질의에 대해서는 쿼리를 생성해내지만, 조금만 프롬프트 표현이 변형되거나 존재하지 않는 데이터를 요구할 때 환각 제어 방법이 없어 가짜 Cypher 문을 생성했기 때문이다(Figure 4).
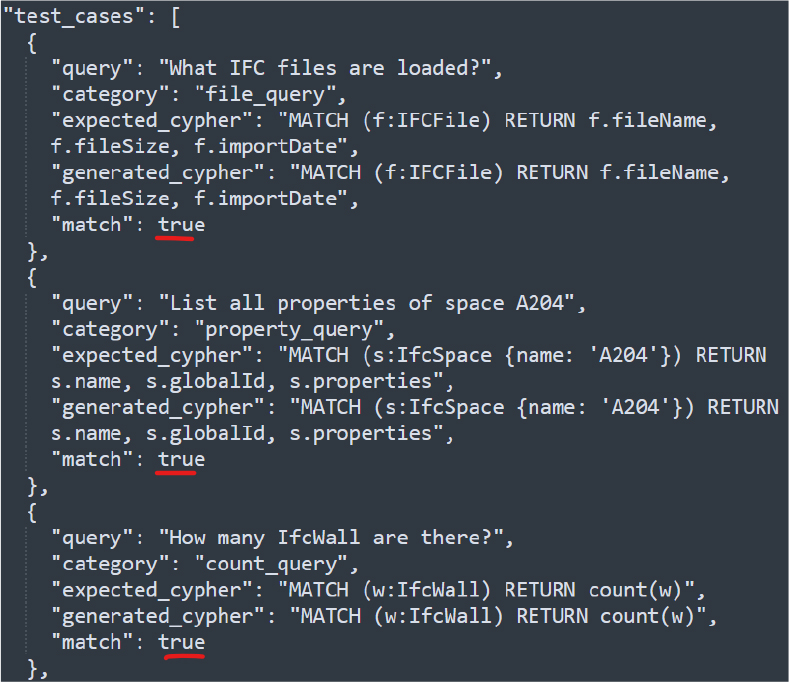
반면, 본 연구에서 제안한 환각 억제 파이프라인 모델은 동일한 가혹 조건 하에서도 21건 중 19건을 완벽하게 필터링하거나 정답 쿼리로 유도해내며 90.48% 정확도를 확인하였다(Figure 5).
두 모델이 완전히 동일한 LLM모델과 그래프 데이터베이스 백엔드를 사용하고 있음에도 불구하고 큰 성능 격차가 발생한 원인은 LLM의 런타임 Cypher Cypher 생성 과정에서의 가드레일 기반 제어 능력 유무에 기인하기 때문이다.
가드레일이 배제된 기본 모델은 정상적인 단순 질의 환경에서는 데이터베이스 구조를 순회하는 Cypher 문을 정상적으로 생성하였으나, 조금만 프롬프트 표현이 왜곡되거나 실제 IFC 스키마에는 존재하지 않는 가짜 속성에 대한 예외 질의가 유입될 경우 이를 스스로 필터링하지 못하고 그대로 허위 Cypher 구문을 생성(환각)하여 실행 연산 실패로 이어졌다. 제안한 방식은 도메인 규칙 지식을 고려한 환각 제어 파이프라인이 적절히 설계되었을 때 좋은 성능을 얻을 수 있음을 의미한다.
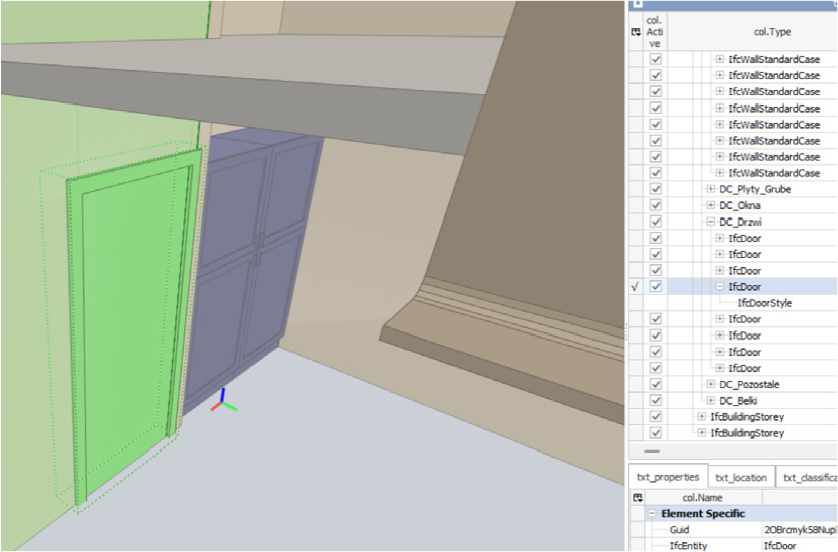
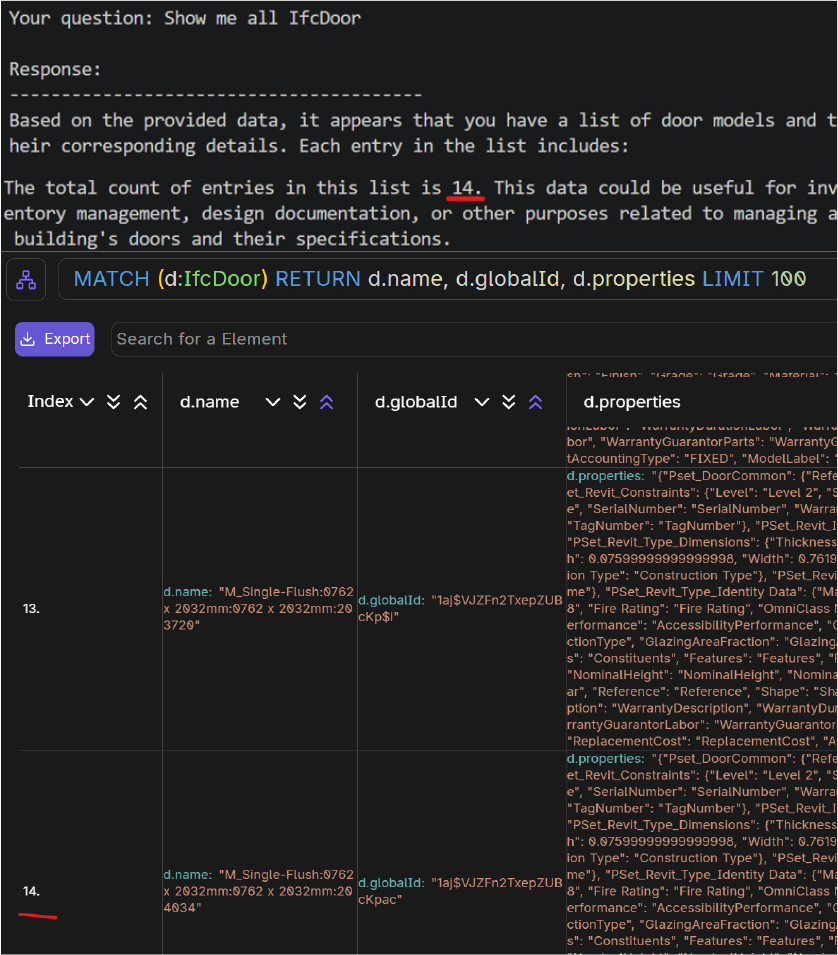
좀 더 직관적인 결과 확인을 위해 테스트셋 중 IfcDoor (Figure 6)에 대한 일부 테스트 자연어 질의(“Show me all IfcDoor”)를 CLI (Command Line Interface) 형식 에이전트를 통해 실행해 확인해 보았다(Figure 7). 테스트 IFC 모델에는 총 14개의 IfcDoor가 있음을 응답하였는데, 이는 해당 Cypher 질의문을 그래프 DB에서 직접 확인해 본 결과와 동일하다.
6.2 세부 환각 유형별 제어 결과 분석
NSP4BIM-RAG 파이프라인의 핵심 모듈들이 구체적으로 어떠한 유형의 환각 에러 패러다임을 차단해냈는지 명확히 파악하기 위해, 질의 유형 세부 카테고리별 매칭 방어 정확도를 분석하였다(Table 2).
Table 2.
Comparative analysis of hallucination defense and processing accuracy by detailed query category
기존 기본 모델은 사용자가 "A204 공간의 공사 비용(cost)을 알려줘"(non_existent_property)라고 입력하거나, "건물 내의 모든 IfcRoom을 나열해줘"(plausible_wrong_label)라고 질문했을 때, 실제 매핑 스키마나 IFC 표준상에는 존재하지 않는 데이터임에도 불구하고 s.cost 같은 허위 Cypher 문을 생성해내어 환각 상태를 보였다.
반면 제안 모델은 Few-shot 단계에서 주입된 거부 규칙과 생성 블랙리스트가 환각 억제 역할을 수행하여, 해당 질의는 데이터베이스로 전달하지 않고 조기에 REFUSE: IfcRoom is not valid. Use IfcSpace를 선언하여 환각 방어가 가능함을 확인할 수 있다. 다만, ambiguous_reference와 complex_relationship 범주는 제안 모델 적용 후에도 정확도가 개선되지 않았다. 이는 본 파이프라인의 환각 제어 기능보다 연구에 적용된 경량 로컬 오픈웨이트 LLM 등 다른 요인이 영향을 미쳤을 가능성이 있다. 이는 향후 연구에서 모델 크기에 따른 영향 등을 조사 및 분석할 계획이다.
연구에서 제안한 주요 가드레일 기법인 정규화, Few-shot 제약의 개별 기여도를 검증하기 위해 요소별 소거 실험을 수행해 보았다(Table 3).
Table 3.
Ablation study of pipeline components (Accuracy)
| Condition | Normalization | Few-shot constraint | Accuracy |
| M1 | X | X | 28.57% |
| M2 | O | X | 57.14% |
| M3 | X | O | 76.19% |
| M4 | O | O | 90.48% |
질의 정규화만 단독으로 적용한 경우(M2) 입력 프롬프트 내 노이즈 토큰이 제거되면서 정확도가 57.14%로 향상되었으며, Few-shot 제약 조건만 단독으로 적용한 단순 조합(M3)의 경우 정형화된 질문 패턴 정의를 통해 76.19%의 정확도를 기록하였다. 두 모듈을 모두 유기적으로 결합한 제안 모델(M4) 환경에서는 입력 정규화와 환각 제어 규칙 간 효과가 극대화되어 90.48%의 성능으로 개선됨을 확인하였다. 이를 통해, 본 연구가 제안하는 파이프라인 구조는 BIM 데이터 질의 시 발생하는 환각 현상을 안정적으로 통제하기 위한 최소한의 구조로 판단된다.
6.3 한계점
본 연구에서 제안한 환각 제어 기법은 LLM의 구문 오류를 사전 방어하는 기법이지만, 시스템 운영 측면에서 한계를 내포한다.
첫째, 퓨샷 기법, LLM 호출 재시도(최대 3회) 등은 LLM 토큰 연산을 증가시켜, 비용 상승이라는 트레이드오프가 존재한다. 이는 정상 질의 응답 대비 토큰 생성에 따른 시간적 지연과 하드웨어 연산 자원 소모를 가중시키는 결과를 초래한다.
둘째, 인간이 정의한 정적 규칙에 대한 종속성이다. 본 가드레일의 핵심인 화이트리스트 기반 라벨 검증 및 블랙리스트 속성 필터링은 엔지니어링 도메인 지식을 갖춘 개발자가 소스코드 수준에서 정의한 하드코딩 규칙에 의존한다. 결과적으로 사용자 정의 속성 집합이 확장될 때는 정적 코드를 업데이트해야 하므로, 확장성 측면에서 한계를 안고 있다.
단, 앞의 문제점들은 현재 테스트에 사용되는 한정된 오픈웨이트 소형 LLM에 영향을 받는 요소가 있어, 적용되는 LLM 파라메터 스케일, GPU 성능 등 다른 변수에 따라 성능이 개선 수 있다.
7. 결 론
본 연구는 객체 간의 복잡한 계층 트리와 공간 위상 네트워크 구조를 내포하는 대용량 BIM IFC 표준 데이터를 Cypher Query와 같은 질의 언어 전문 지식이 없는 일반 실무자도 자연어로 환각없이 탐색할 수 있도록 지원할 수 있도록, 지식그래프 기반 RAG 프레임워크를 구축하고, 대규모 언어 모델의 유연한 입력 변이성 조건에서 발생하는 환각 현상을 실시간 제어하는 환각 억제 파이프라인 메커니즘을 제안하였다.
테스트를 위해 총 21개의 가혹 조건 쿼리셋을 바탕으로 정량적 검증을 수행한 결과, 제안 모델은 비정형적이고 왜곡된 프롬프트 변이 인입 환경 속에서도 그럴듯한 가짜 쿼리 생성을 제어하여 정확도 기준 Baseline의 28.57%에서 90.48%까지 성능을 개선하였다.
이를 통해, 존재하지 않는 속성 요구나 스키마 결함, SQL 혼입 문법 등을 파이프라인 내부 검증 루프(Cypher Validator)와 동적 재시도 알고리즘 메커니즘을 통해 필터링하고 자가 복구할 수 있음을 확인하였다.
본 연구 결과는 복잡한 그래프 질의어(Cypher)를 모르는 비전문가도 자연어 인터페이스만을 활용해 BIM과 같은 객체지향 및 그래프 모델 구조 데이터에 효과적으로 질의할 수 있는 건설 정보 시맨틱 인터페이스의 환각 제어 기술로 응용될 수 있다.
단, 본 연구의 실험 검증은 제한된 질의 시나리오와 표준 IFC 단일 모델, 그리고 오픈웨이트 LLM 환경 하에서 수행되었다. 이는 대규모 복합 시설의 방대한 데이터 실무 환경을 완벽히 대변하기에는 통계적 표본의 규모가 작으며, 세부 범주별 높은 정확도는 일반화된 통계 지표라기보다 특정 시나리오에 대한 가드레일의 유효성을 정성적으로 입증한 사례 연구에 가깝다는 명확한 구조적 한계를 지닌다.
본 논문은 인프라 자원이 한정된 경량 로컬 온프레미스 환경에서 가드레일 메커니즘이 작동할 수 있는 기초 실효성을 입증하는 데 초점을 맞추었다. 따라서 실제 대규모 복합 엔지니어링 시설물에 본 시스템을 적용할 경우 그래프 스캔 속도 저하 및 고차원 다중 관계 연산 시의 추론 병목 현상이 발생할 수 있어, 이를 최적화하고 표본 데이터셋을 대대적으로 확장하는 연구를 향후 연구 과제로 추진할 계획이다.