

1. 서 론
1.1 연구의 배경 및 목적
1.2 연구의 범위 및 방법
2. 이론적 고찰
2.1 건축·실내공간 분야의 디지털 데이터 및 AI 활용
2.2 AI 기반 공간 이미지 분석 선행연구
2.3 호텔 브랜드 공간의 정성적 평가기준과 연구차별성
3. AI 기반 브랜드 공간 정합성 평가 방법
3.1 연구 프레임워크
3.2 브랜드 코드북 및 평가체계 구축
3.3 공간 이미지 데이터셋 구축
3.4 VLM 기반 공간 이미지 평가
3.5 HITL 기반 평가 검증
4. 분석결과
4.1 AI 기반 브랜드 공간 정합성 평가 결과
4.2 AI–전문가 평가 비교 및 검증
4.3 AI–전문가 판단 불일치 사례 분석
5. 결 론
5.1 연구결과 및 의의
5.2 연구한계 및 향후 연구
1. 서 론
1.1 연구의 배경 및 목적
건축·공간 분야에서는 BIM (Building Information Modeling)을 중심으로 설계정보를 디지털화하고, 이를 설계, 시공, 운영 단계에서 통합적으로 활용하기 위한 연구가 지속되어 왔다. 최근에는 이러한 데이터 기반 설계 환경이 인공지능(Artificial Intelligence, AI)기술과 결합되면서, 공간 이미지와 같은 비정형 시각정보를 생성하고 데이터로 구축·활용하는 방향으로 연구 범위가 확장되고 있다(Yoo and Lee, 2024; Kim and Lee, 2024). 나아가 AI로 생성된 외관 패턴 이미지를 BIM 환경의 3D 모델로 자동 변환하여 설계 실행 단계로 연결하려는 시도도 제시되었다(Yoo et al., 2025). 이처럼 AI 기반 시각정보의 활용범위가 확대되고 있으나, 기존 연구는 주로 설계과정에서 활용되는 시각정보의 생성·구축과 분석, 모델링 연계에 초점을 두고 있어, 시각정보를 사전에 정의된 정성적 디자인 기준에 따라 평가하는 방법에 대해서는 추가적인 연구가 필요하다.
이와 함께 설계정보가 사전에 정의된 기준을 충족하는지를 자동으로 검토하기 위한 연구도 진행되고 있다. BIM 기반 설계 데이터 평가 연구에서는 인증기준 등의 평가 조건을 구조화하여 설계정보와 비교함으로써 기준 충족여부를 검토하는 방법이 제안되었으며(Yu et al., 2024), 이는 동일한 기준을 설계 정보에 반복적으로 적용할 수 있다는 점에서 의미가 있다. 그러나 색채, 소재·마감, 공간 분위기, 톤앤매너와 같은 정성적 디자인 속성은 단일한 수치 조건이나 명시적인 규칙으로 정의하기 어렵고, 공간의 전체적인 시각적 맥락을 함께 해석해야 하므로, 전문가의 경험과 해석에 의존하는 경우가 많으며 평가자에 따라 판단에 차이가 발생할 수 있다. 따라서 정성적 디자인 속성의 평가에는 평가기준을 명확하게 구조화하여 일관되게 적용할 수 있는 방법이 요구된다. 이를 위해 최근에는 이미지와 텍스트를 함께 처리하는 멀티모달 AI를 활용하여 건축 디자인의 특성을 정량화하거나, 특정 디자인 스타일과의 유사도 및 일치도를 측정하려는 연구가 이루어지고 있다(Yoo and Lee, 2025a, 2025b; Yoo et al., 2025).
다만 이러한 접근은 디자인이 어떠한 시각적 특성을 갖는지, 또는 특정 스타일의 특징값과 얼마나 유사한지를 측정하는 것으로, 선행연구에서도 정량화가 디자인의 정합성을 직접 평가하지는 않으며 적합성 판단을 위해서는 별도의 평가기준이 필요함을 제시하였다(Yoo and Lee, 2025a; 2025b). 또한 제안된 방법의 성능과 정확도를 전문가 대상의 실증을 통해 검증하는 것이 후속 과제로 제시되었다(Yoo and Lee, 2025a). 따라서 사전에 정의된 정성적인 디자인 기준을 하나의 평가 체계로 구조화하여 공간 이미지의 기준 부합 정도를 평가하고, 그 결과를 전문가 평가와 비교·검증하는 방법에 대한 연구가 필요하다.
이러한 평가의 필요성은 공통된 디자인 기준을 다수의 공간에 반복적으로 적용하고 관리해야 하는 환경에서 보다 구체적으로 나타난다. 호텔, 리테일 매장, 프랜차이즈 상업시설과 같이 다수의 지점이나 프로퍼티를 운영하는 공간에서 브랜드 또는 운영 주체가 설정한 동일 디자인 매뉴얼·기준을 개별 공간에 지속적으로 적용해야 하며, 다수의 공간을 대상으로 브랜드 스탠다드와의 디자인 정합성을 동일한 관점에서 반복적으로 검토하는 데에는 상당한 시간과 노력이 요구된다. 본 연구는 이 중 호텔 브랜드 공간을 적용대상으로 선정하였다. 호텔 브랜드는 성급별 브랜드 스탠다드를 통해 공간 디자인의 방향과 기준을 설정하고, 이를 다수의 프로퍼티에 적용하므로, 평가기준을 구조화하기 위한 근거가 명확하다. 특히 소유와 운영이 분리된 위탁운영(Management Contract) 구조에서는 소유주와 운영사 간 이해관계의 차이로 브랜드 기준의 적용 및 준수 과정에서 갈등이 발생할 수 있어(de Roos, 2010; Turner and Guilding, 2010), 다수의 프로퍼티에 적용된 브랜드만의 공간 기준 정합성을 지속적으로 검토, 관리할 필요가 있다. 이러한 특성에서 호텔 브랜드 공간은 공통된 정성적 디자인 기준을 다수의 공간에 반복 적용하는 평가 방법을 검토하기 위한 적용 대상으로 활용할 수 있다.
이에 본 연구는 정성적 공간 디자인 기준을 구조화된 평가기준으로 변환하고, 이를 동일한 절차로 반복 적용하여 실제 공간 이미지의 기준 정합성을 평가하는 AI 기반 보조 평가 방법을 제안하는 것을 목적으로 한다. 구체적으로 첫째, 호텔 브랜드의 공간 아이덴티티 및 브랜드 스탠다드를 7개 평가항목으로 구성된 브랜드 코드북(Brand Codebook)으로 구조화하고, 둘째, 브랜드 코드북을 고정된 평가기준(reference)으로 설정하여 Vision-Language Model(VLM)이 공간 이미지와 평가기준 간의 정합성을 동일한 절차에 따라 평가하도록 하며, 셋째, 동일한 평가기준을 적용한 전문가 평가(Human-in-the-Loop, HITL)와 AI 평가 결과를 비교하여 제안 방법의 적용 가능성과 한계를 검증한다. 실제 연구에서는 브랜드별 코드북을 고정된 평가기준으로 설정하고 497장의 공간 이미지를 평가 대상으로 하여 7개 항목의 정합성을 평가하도록 설계하였다.
본 연구에서 AI는 전문가의 디자인 판단을 대체하는 평가 주체가 아니라, 정성적으로 판단되어 온 디자인 요소를 구조화된 평가기준에 따라 수치화하고 이를 다수의 공간 이미지에 반복 적용하는 보조 도구로 활용하였다.
이를 통해 본 연구는 건축, 공간 분야에서 발전해 온 AI 기반 시각정보의 생성·구축, 인식·정량화 및 유사도 측정에서 나아가 이미지를 통한 공간 분위기, 소재·마감, 톤앤매너 등의 정성적인 디자인 요소를 평가 가능한 기준으로 구조화하고 실제 공간의 기준 부합 정도를 평가하는 방법으로 AI 활용의 범위를 확장하고자 한다.
1.2 연구의 범위 및 방법
본 연구는 건축·공간 분야에서 발전해 온 데이터 기반 정보 활용과 AI 기반 시각정보 분석을 바탕으로, 공간 이미지에 나타나는 정성적 디자인 속성을 구조화된 기준에 따라 평가하는 방법에 초점을 둔다. 연구의 적용 대상은 Marriott International, Hilton Worldwide, Hyatt Hotels Corporation 및 Lotte Hotels & Resorts 등 글로벌 4개 호텔 그룹에 속한 12개의 브랜드와 50개 프로퍼티로 설정하였다. 연구 대상에는 Luxury, Upper Upscale, Lifestyle, Business의 브랜드 티어와 로비, 공용부, F&B, 피트니스 등의 주요 공간 유형을 포함하였다. 평가 이미지는 각 프로퍼티당 10장을 기준으로 총 500장을 구성하였으며, 수집 및 전처리 과정에서 확인된 오류 이미지를 제외한 총 497장을 최종 AI평가 데이터로 활용하였다.
연구는 크게 세 단계로 수행하였다. 첫째, 평가기준 구조화 단계에서는 호텔 브랜드의 공간 아이덴티티 및 브랜드 스탠다드와 관련된 정보를 분석하여 7개 평가항목과 항목별 판단기준으로 구성된 브랜드 코드북을 구축하였다. 구축된 코드북은 평가 과정에서 변경되지 않는 고정된 평가기준(reference)으로 설정하고, 각 공간 이미지를 평가변수(variable)로 설정하였다. 이를 통해 서술적·정성적 형태의 브랜드 공간 기준을 AI와 전문가가 공통적으로 참조할 수 있는 평가체계로 구조화하였다.
둘째, VLM 기반 공간 이미지 평가 단계에서는 연구대상 프로퍼티의 공간 이미지를 동일한 기준에 따라 수집·선별하고 전처리하여 평가 데이터셋을 구축하였다. 이후 VLM에 브랜드별 코드북과 표준화된 평가 절차를 동일하게 적용하여 전체 공간 이미지를 색채 정합성, 소재·마감 정합성, 공간 분위기 정합성, 브랜드 톤앤매너 정합성, 공간 유형 적합성, 현지화·지역성, 종합 브랜드 아이덴티티 정합성의 7개 항목에 대해 1~10의 척도로 평가하도록 하였다. 또한 각 항목의 점수와 판단 근거를 구조화된 형식으로 출력하여 동일한 평가체계가 전체 이미지에 반복적으로 적용되도록 구성하였다.
셋째, HITL (Human-in-the-loop)기반 검증 단계에서는 AI 평가 결과의 적용 가능성과 한계를 확인하기 위하여 전체 데이터 중 AI 평가점수와 각 브랜드, 티어, 공간 유형의 다양성을 고려하여 24장의 대표 이미지를 선정하였다. 실내·공간디자인, TS실무 및 개발, 브랜드 기획·관리 분야의 전문가 30명이 AI와 동일한 7개 평가항목과 1~10점 척도를 사용하여 독립적으로 평가하도록 하였으며, 평가 시 해당 이미지의 브랜드 코드북 핵심 기준을 함께 제시하여 AI와 전문가가 동일한 기준을 참조하도록 구성하였다. AI와 전문가의 평가 결과는 Pearson 상관계수와 Spearman 순위상관계수를 중심으로 비교하였으며, Cohen의 가중 카파(weighted κ)를 보조 지표로 활용하여 절대적 일치 수준을 함께 검토하였다.
이러한 비교 검증은, AI와 전문가의 판단이 동일함을 전제하거나 AI가 전문가를 대체할 수 있음을 입증하기 위한 것이 아니라, 두 평가 간의 관계와 절대적 일치 수준을 구분하여 AI 기반 보조 평가의 적용범위와 한계를 확인하기 위한 것이다. 따라서 본 연구의 전체 과정은 공간 디자인 정성적 평가 기준의 구조화 및 브랜드 코드북 구축, VLM 기반 공간 이미지 정합성 평가, HITL 기반 전문가 비교, 검증의 세 단계로 구성된다.
2. 이론적 고찰
2.1 건축·실내공간 분야의 디지털 데이터 및 AI 활용
건축·실내공간 분야에서는 BIM을 중심으로 설계정보를 디지털화하고 활용하는 연구와 함께, AI를 활용하여 공간의 시각정보를 생성·구축하고 이를 설계 및 모델링 과정과 연계하려는 연구가 이루어지고 있다. 생성형 AI를 활용하여 초기설계 단계에서 건축가의 스타일이 반영된 외관 디자인 대안을 시각화하는 방법이 제안되었으며, 이를 통해 기존 3D 모델링 및 렌더링 과정에 소요되는 시간과 작업을 줄이면서 다양한 디자인 대안을 생성할 수 있는 가능성이 제시되었다(Yoo and Lee, 2024). 또한 360 카메라, 3D 스캐닝, BIM 모델링 및 이미지 생성 AI 등을 활용하여 약 10,000장 규모의 실내공간 파노라마 이미지 데이터베이스를 구축하고, 객체 인식 기반 공간 분류와 깊이 정보를 활용한 대표 이미지 선별 방법이 제안되었다(Kim and Lee, 2024). 이는 공간 이미지를 단순한 시각화 자료를 넘어 구축·분류·분석이 가능한 데이터로 활용할 수 있는 가능성을 보여준다.
나아가 AI로 생성된 시각정보를 설계정보와 연결하려는 연구도 이루어지고 있다. AI로 생성된 건축물 외관 패턴 이미지를 2D-to-3D 알고리즘을 통해 BIM환경에서 활용 가능한 3D 모델로 자동 변환하는 방법이 제안되었으며(Yoo et al., 2025), 이는 생성형 AI의 활용범위를 이미지 생성 및 시각화에서 실제 설계정보의 구축과 BIM모델링 단계로 확장한 접근으로 볼 수 있다. 이러한 연구들은 건축·공간 분야에서 이미지 기반 시각정보가 설계과정에서 활용 가능한 디지털 데이터로 확장될 수 있음을 보여준다.
한편 BIM 기반 설계 정보를 사전에 정의된 기준과 비교하여 기준 충족 여부를 검토하는 연구들도 이루어져 왔다. BIM 데이터에 포함된 건축정보, 형상정보 및 속성정보를 평가기준과 연계하여 자동으로 검토하는 방식이 활용되고 있다(Yu et al., 2024). Yu et al. (2024)은 장애물 없는 생활환경(Barrier Free) 인증기준을 평가 로직으로 구현하고 BIM 모델의 객체 정보를 산출기준과 비교하여 등급을 판정하는 자동 평가 시스템을 활용하였으며, 인증기준이 변경될 때마다 프로그램 코드를 수정해야 하는 기존 방식의 한계를 해결하기 위해 대화형 AI를 활용하여 평가 로직을 해석하고 변경된 기준을 반영하는 방법을 제안하였다. 이러한 자동 평가는 평가 대상이 속성정보로 구조화되고 기준이 그 속성값과 비교 가능한 수치조건으로 정의될 때 작동하며, 표준화되지 않은 데이터는 평가에서 누락될 수 있다(Yu et al., 2024).
이처럼 건축·실내공간 분야의 디지털 데이터 및 AI 활용은 공간의 시각정보를 생성·구축하고 이를 설계 및 모델링 과정과 연계하는 방향과, 구조화된 설계정보를 사전에 정의된 기준과 비교하는 방향으로 확장되어 왔다. 이러한 흐름과 함께 최근에는 AI를 활용하여 공간 이미지 자체에 나타나는 시각적 특성과 정성적 판단이 수반되는 디자인 요소를 분석하고 평가하려는 연구도 이루어지고 있으며, 이에 대해서 다음 절에서 구체적으로 살펴보고자 한다.
2.2 AI 기반 공간 이미지 분석 선행연구
건축·공간 이미지 분석은 전통적으로 전문가가 형태, 색채, 재료, 구성 등 다양한 시각적 특징을 관찰하고 이를 바탕으로 해석하는 정성적 방식을 중심으로 이루어져 왔다. 이러한 방식은 디자인에 대한 심층적 이해를 가능하게 하는 한편, 평가자의 경험과 판단에 따라 동일한 대상에 대해서도 해석의 차이가 발생할 수 있으므로, 다수의 대상을 일관된 기준으로 비교하기 위해서는 이러한 차이를 줄일 수 있는 체계적인 분석 방법이 함께 요구된다(Yoo and Lee, 2025a; 2025b). 이에 따라 AI를 활용하여 디자인의 시각적 특성을 분석하려는 연구가 이루어져 왔다. 초기에는 CNN 기반의 스타일 분류가 시도되었으나, 판단 과정의 해석이 어렵고 학습된 범주를 중심으로 결과가 도출되어 모델이 어떠한 시각적 특성을 근거로 판단하였는지 구체적으로 설명하기 어렵다는 한계가 제시되었다(Yoo and Lee, 2025a; 2025b). 또한 건축가별 평가 키워드를 정의하고 생성 이미지에 해당 특성이 반영되었는지를 평가하는 방식도 활용되었으나, 평가 과정이 연구자의 수작업에 의존한다는 한계가 있었다(Yoo and Lee, 2024; 2025b).
이러한 흐름은 이미지와 텍스트를 함께 처리하는 멀티모달 AI를 활용한 분석 및 정량화 연구로 이어졌다. CLIP모델을 활용하여 곡선성, 채도, 투명성, 대칭성 등의 시각적 특성을 상반된 두 상태 사이의 0~1값으로 정량화하는 방법이 제안되었으며(Yoo and Lee, 2025a), 특정 스타일의 이미지들에서 도출한 대표 특정값을 기준으로 입력 이미지와의 유사도를 산출하여 스타일을 분류하고, 큐레이션하는 시스템으로 발전하였다(Yoo and Lee, 2025b). 또한 스타일 키워드와 생성 이미지 간의 의미적 유사도를 측정하여 생성 결과의 스타일 재현 정도를 평가하는 방법도 활용되었다(Yoo et al., 2025). 이러한 연구는 정성적으로 인식되어 온 시각적 특성과 스타일의 유사성을 정량적으로 표현하고, 다수의 이미지에 동일한 분석 절차를 적용할 수 있음을 보여주었다.
이들 연구는 건축 디자인의 시각적 특성을 정량적으로 비교하기 위한 기반을 마련하였으며, 단일 이미지에서 직접 관찰 가능한 보편적 시각특성을 주요 분석 대상으로 설정하였다(Yoo and Lee, 2025a). 그러나 정량화된 특성값은 이미지가 어떠한 시각적 특성을 갖는지를 나타내는 것으로, 그 자체가 디자인의 우수성이나 가치를 평가하거나 특정 기준에 대한 정합성을 판단하는 것은 아니다. 따라서 질적 평가를 위해서는 비교 대상군의 설정과 함께 명확한 평가기준이 추가로 필요함이 제시되었다(Yoo and Lee, 2025a; 2025b). 또한 제안된 정량화 방법의 성능과 정확도를 검증하기 위한 후속 과제로 건축 전문가를 대상으로 한 실증적 검증의 필요성이 제시되었다(Yoo and Lee, 2025a).
한편 AI를 평가자로 활용하는 연구에서는 AI에 인간이 수행하는 평가와 동일한 지시와 평가 문항을 제시하고 그 결과를 전문가 평가와 비교하거나(Chiang and Lee, 2023), AI 평가자와 인간 평가 간의 일치수준을 측정하는 방식으로(Zheng et al., 2023) 평가 결과의 신뢰성과 적용 범위를 검토하고 있다. 이러한 선행 연구를 종합하면, AI 기반 공간 이미지 분석은 이미지 분류에서 시각적 특성의 정량화, 나아가 스타일 유사도 측정으로 발전해 왔다. 이를 통해 공간 이미지가 “무엇과 유사한가”를 일관된 절차로 측정할 수 있는 기반이 마련되었다. 이를 바탕으로 공간 이미지가 특정 디자인의 기준을 “어느 정도 충족하는가”를 평가하기 위해서는 평가의 기준이 되는 정성적 디자인 정보를 정의하고, 구조화하는 방법과 AI의 판단과 전문가의 평가를 비교, 검증하는 절차를 함께 설계할 필요가 있다.
2.3 호텔 브랜드 공간의 정성적 평가기준과 연구차별성
호텔 브랜드 공간은 각 브랜드가 지향하는 공간적 정체성을 다수의 프로퍼티에 일관되게 구현하기 위해 색채, 소재·마감, 공간 분위기 등 다양한 디자인 기준을 설정하고 이를 실제 공간에 적용한다. 이러한 기준은 글로벌 호텔 브랜드의 브랜드 스탠다드(Brand Standards) 등의 문서를 통해 제시되며, 호텔의 개발 및 설계과정에서는 Technical Services(TS)를 통해 개별 프로젝트의 설계가 브랜드 기준에 부합하는지를 검토하고 조정한다. 특히 호텔 경영방식 중 하나인 위탁운영(Management Contract) 구조에서는 소유주와 운영사 간 이해관계의 차이로 브랜드 기준의 준수를 둘러싼 갈등이 발생할 수 있으며(de Roos, 2010; Turner and Guilding, 2010), 이에 따라 브랜드가 설정한 공간 디자인 기준과 실제 공간의 구현 결과 간 정합성을 지속적으로 검토할 필요가 있다.
한편 이러한 브랜드 공간의 디자인 기준은 색채와 소재·마감과 같이 비교적 구체적으로 확인할 수 있는 요소뿐만 아니라 공간 분위기나 톤앤매너와 같이 복합적인 해석이 필요한 정성적 요소를 함께 포함한다. 따라서 이러한 디자인 정보를 실제 공간에 대한 평가기준으로 활용하기 위해서는 브랜드별로 일정한 체계에 따라 평가 가능한 형태로 구조화하는 과정이 필요하다. 이와 관련하여 실내 공간 분야에서는 디자인 스타일의 특성을 디자인 요소, 마감재, 색상, 분위기 등의 키워드로 정리하여 이미지 생성과 공간 시각화에 활용하는 연구가 이루어졌다(Jeong and Lee, 2023). 호텔 공간에서도 SNS 이미지를 분석하여 라이프스타일 호텔의 공간 프로그램과 디자인 요소를 도출하거나(Han and Lee, 2023), 생성형 AI를 활용하여 호텔 로비를 시각화하고 디자인 요소를 분석하는 연구가 수행되었다(Choi and Jung, 2024). 최근에는 멀티모달 분석을 통해 건축 디자인 언어를 해석하거나(Park et al., 2025), LLM 기반 평가를 인간 평가와 비교하는 연구(Lee and Heo, 2025)도 이루어지고 있다. 이러한 연구들은 AI의 활용이 공간 이미지의 생성과 시각적 특성 분석을 넘어 의미적 해석과 평가 영역으로 확장되고 있음을 보여준다.
본 연구는 이러한 선행연구를 바탕으로 호텔 브랜드별 고유한 정성적 공간 기준을 브랜드 코드북(Brand Codebook)으로 구조화하고, 이를 VLM에 고정된 평가기준으로 적용한다. 브랜드 코드북은 7개의 평가 항목으로 구성되며, 색채, 소재·마감, 공간 분위기, 톤앤매너 등 브랜드가 지향하는 공간적 특성을 항목별 판단 기준으로 구체화한다. VLM은 텍스트로 기술된 코드북 기준과 공간 이미지를 함께 입력받아 각 평가 항목에 대한 정합성 점수와 판단 근거를 도출함으로써, 서술적으로 표현된 디자인 기준에 대한 실제 공간의 부합정도를 평가하는 도구로 활용된다. 또한 AI와 동일한 코드북 기준을 제시한 전문가 평가와 결과를 비교함으로써, AI를 전문가의 디자인 판단을 대체하는 평가 주체가 아니라 정성적 디자인 기준을 다수의 공간 이미지에 반복 적용하는 보조 평가 도구로 활용할 수 있는 가능성과 한계를 검토한다.
본 연구와 선행연구의 관계는 Table 1과 같이 정리할 수 있다. 기존 멀티모달 AI 기반 건축 이미지 연구는 다양한 스타일을 폭넓게 비교하기 위해 특정 스타일에 한정된 개별 요소보다 다양한 건축물에 적용 가능한 보편적 특성을 기준으로 삼았으며(Yoo and Lee, 2025b), 이는 다양한 건축 디자인의 시각적 특성을 동일한 체계에서 비교, 분류하기 위한 연구 목적에 부합하는 접근이다. 반면 본 연구는 특정 브랜드가 지향하는 고유한 디자인 기준에 대한 부합정도를 평가하는 것을 목적으로 하므로, 평가기준을 보편적 시각특성에서 브랜드별 고유한 정성적 디자인 기준으로 확장하고, 평가 결과를 스타일 유사도에서 사전에 정의된 기준에 대한 충족 정도(정합성)로 설정하였다. 즉, 기존 멀티모달 AI 기반 연구가 공간 이미지의 시각적 특성을 정량화하고 이를 바탕으로 “무엇과 유사한가”를 분석하였다면, 본 연구는 브랜드별 정성적 디자인 기준을 구조화하여 실제 공간이 “사전에 정의된 기준에 어느 정도 충족하는가”를 평가하는 방법으로 확장한다.
Table 1.
Comparison between previous studies and this study
| Researcher | Analysis method | Contents |
| Yu et al. (2024) | Rule-based automated evaluation of BIM data; AI-assisted revision of evaluation logic | Evaluates BIM design data against structured certification criteria (e.g., door clear width) and assigns grades |
| Yoo and Lee (2024) | Generative AI fine-tuned on architect styles | Visualizes exterior design alternatives; evaluates style reflection by keyword-based scoring and CLIPScore |
| Kim and Lee (2024) | 360° panoramic image database; object recognition and depth-based selection | Constructs and classifies interior spatial image data for design reference |
| Yoo et al. (2025) | AI image generation and 2D-to-3D conversion | Converts generated façade pattern images into BIM-compatible 3D models; evaluates by CLIPScore and SSIM |
| Yoo and Lee (2025a, 2025b) | CLIP-based quantification and similarity measurement | Quantifies general visual features (0–1) and classifies styles by similarity to reference feature values |
| This study | Brand codebook + VLM evaluation + HITL validation | Evaluates alignment of hotel interior images with brand-specific qualitative criteria (7 criteria, 1–10 scores with rationales) and validates results with 30 experts |
3. AI 기반 브랜드 공간 정합성 평가 방법
3.1 연구 프레임워크
본 연구는 호텔 브랜드 공간 디자인의 정성적 기준을 구조화하고, 이를 기반으로 실제 공간 이미지의 브랜드 아이덴티티 정합성을 평가하는 AI 기반 보조 평가 방법을 제안한다. 연구의 기본 구조는 각 브랜드가 지향하는 공간적 특성을 브랜드 코드북(Brand Codebook)으로 구조화하여 고정된 평가기준(reference)으로 설정하고, 실제 호텔 공간 이미지를 평가변수(variable)로 입력하여 Vision-Language Model(VLM)이 기준과 이미지 간의 정합성을 평가하도록 구성하였다. 이와 같이 평가기준과 평가대상을 분리함으로써 동일 브랜드의 모든 이미지는 동일한 기준과 평가절차를 반복 적용하고, 공간 이미지에 따른 정합성 평가 결과의 차이를 비교할 수 있도록 하였다. 이후 동일한 평가기준을 적용한 전문가 평가를 수행하고 AI 평가 결과와 비교함으로써 제안 방법의 적용 가능성과 한계를 검토하였다.
연구 절차는 Figure 1과 같이 평가 기준 구조화, VLM 기반 평가, HITL 기반 검증의 세 단계와 네 개의 세부 절차로 구성하였다. 평가 기준 구조화 단계에서는 연구대상 호텔 브랜드의 공간 디자인 관련 기준을 수집·분석하여 브랜드별 코드북과 평가체계를 구축하였다. VLM 기반 평가 단계에서는 연구대상 호텔 브랜드의 실제 공간 이미지를 수집·선별하여 평가 이미지 데이터셋을 구축하고, 이미지 평가를 수행하였다. HITL 기반 검증 단계에서는 대표 이미지를 대상으로 전문가 평가를 실시하고, AI와 전문가 평가 결과를 비교·분석하여 VLM 기반 브랜드 공간 정합성 평가의 활용 가능성과 한계를 검토하였다.
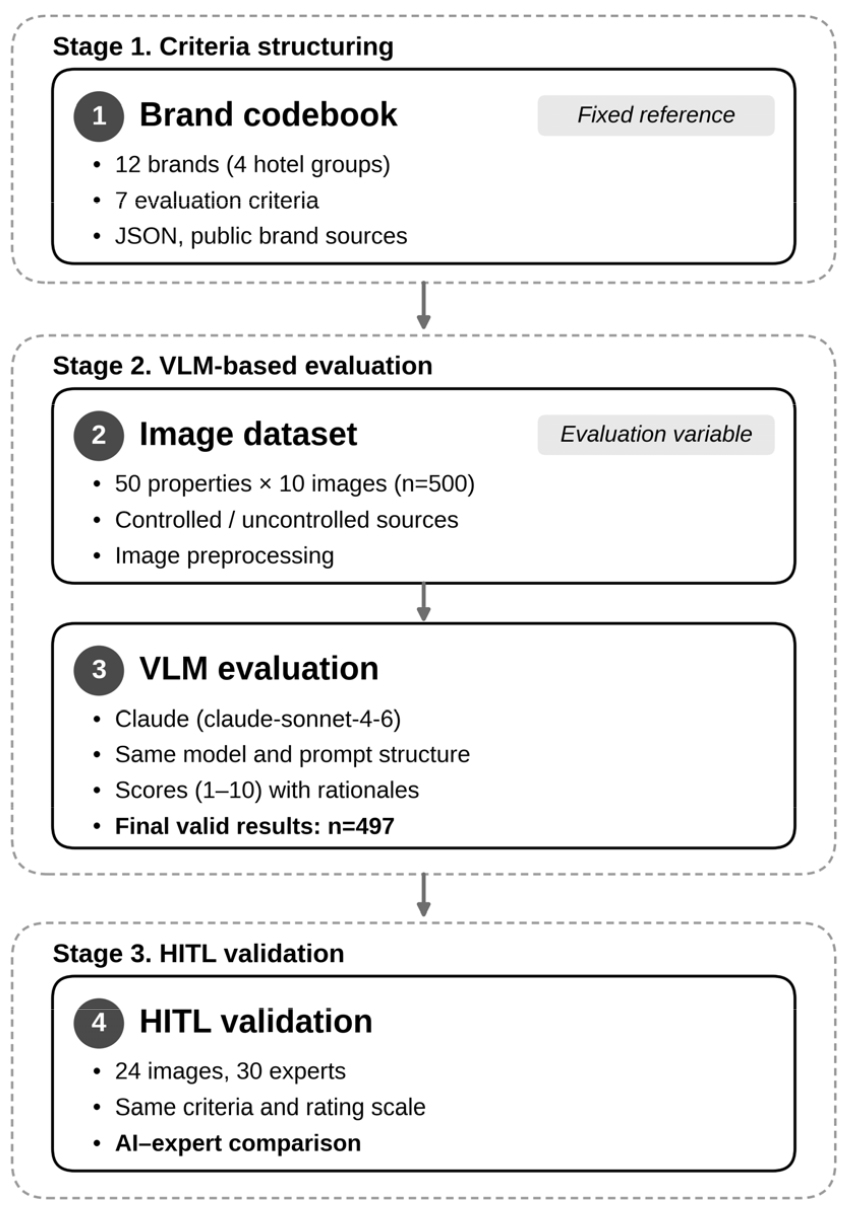
본 연구 프레임워크에서 AI는 구조화된 코드북을 기준으로 다수의 공간 이미지에 반복 적용하는 보조 평가 도구로 활용되며, 전문가 평가와의 비교를 통해 AI 평가 결과와 전문가 판단 간의 관계 및 적용 범위를 검토한다.
3.2 브랜드 코드북 및 평가체계 구축
호텔 브랜드의 공간 아이덴티티는 색채, 소재·마감, 공간 분위기, 톤앤매너 등 다양한 정성적 요소의 조합으로 나타난다. 본 연구에서는 이러한 브랜드별 공간 디자인 정보를 VLM과 전문가가 동일한 기준에 따라 해석하고 평가할 수 있도록 브랜드 코드북의 형태로 구조화하였다. 브랜드 코드북은 브랜드별 공간 아이덴티티를 설명하는 정성적 디자인 기준을 항목별로 정리한 평가 참조체계로, 평가 과정에서는 변경되지 않는 고정된 기준(Reference)으로 적용하였다.
코드북은 연구대상인 12개 브랜드에 대해 각각 구축하였으며, ① 자료 수집, ② 공간 디자인 정보 추출, ③ 평가항목별 분류 및 구조화, ④ 출처 기록, ⑤ JSON 변환의 순서로 구축하였다. 먼저 각 브랜드의 공식 홈페이지, 브랜드 소개자료, 공식 보도자료 및 공개된 디자인 관련 자료 등 브랜드가 직접 제공하는 공식자료를 우선적인 근거자료로 수집하였다. 수집된 자료에서 브랜드 포지셔닝 및 핵심가치와 함께 색채, 소재·마감, 공간 분위기, 공간 연출 특성, 공간 유형별 특성 및 지역적 표현 등 공간 디자인과 관련된 내용을 추출하였다.
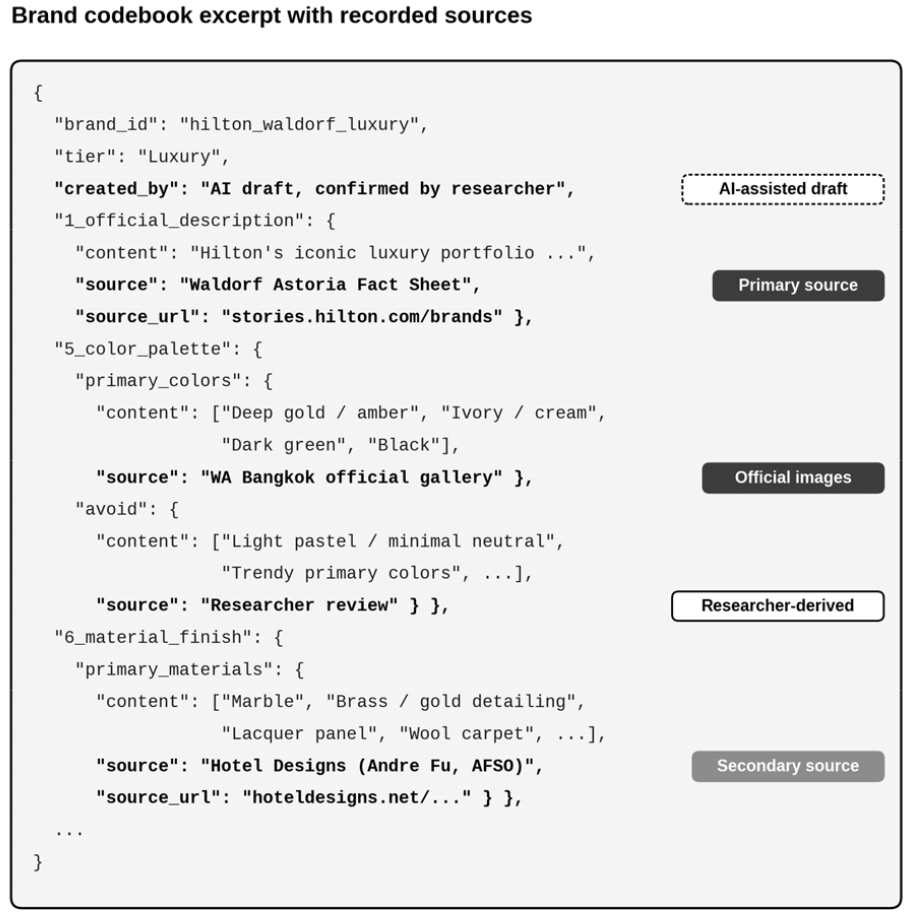
추출된 정보는 브랜드 포지셔닝 및 핵심가치, 공간 아이덴티티 키워드, 색채 팔레트, 소재 및 마감, 공간 분위기, 대표 공간 특성, 지역 특화요소 및 브랜드 기준 부적합 요소 등의 공통 항목으로 분류하였다. 공식자료만으로 공간적 특성을 구체화하기 어려운 경우에는 호텔·디자인 전문매체의 공간 및 디자인 관련 설명을 보완적으로 참고하였으며, 이는 공식자료에서 확인된 브랜드 방향성을 공간적 표현으로 구체화하기 위한 보조자료로 활용하였다. 일부 브랜드에서 온라인으로 공개한 디자인 가이드 역시 공간 특성을 구체화하기 위한 자료로 활용하였다. 내부 비공개 문서에는 의존하지 않는 것을 원칙으로 하였다. 구조화된 브랜드별 공간 디자인 정보는 VLM이 동일한 형식으로 참조할 수 있도록 JSON 형태로 변환하였다. 실제 코드북의 구조와 출처정보 기록 방식의 예시는 Figure 2와 같다. 최종 코드북은 평가 시작 전에 확정하고 평가 과정에서 수정하지 않았으며, 각 공간 이미지는 해당 브랜드의 코드북만을 기준으로 독립적으로 평가하였다.
평가체계는 Table 2와 같이 색채 정합성, 소재·마감 정합성, 공간 분위기 정합성, 브랜드 톤앤매너 정합성, 공간 유형 적합성, 현지화·지역성, 종합 브랜드 아이덴티티 정합성의 7개 항목으로 구성하였다. 각 항목은 1~10점 척도로 평가하도록 설정하였으며, VLM이 점수와 함께 해당 점수를 부여한 판단 근거를 함께 제시하도록 구성하였다. 이때 평가 점수는 공간 자체의 심미적 완성도나 시공 품질을 평가하는 것이 아니라, 해당 공간에 나타난 디자인 특성이 소속 브랜드 코드북에 정의된 기준에 어느 정도 부합하는지 나타낸다. 1~6번 항목은 색채, 소재·마감, 공간 분위기, 톤앤매너, 공간 유형 및 현지화·지역성에 대한 개별 기준의 부합 정도(alignment)를 평가하며, 7번 항목은 공간 전반에 나타나는 종합적인 브랜드 아이덴티티 정합성(overall identity coherence)을 평가하도록 구성하였다. 또한 브랜드 코드북은 각 브랜드의 공통적인 디자인 특성을 기준으로 평가하되, 개별 프로퍼티가 위치한 지역의 문화적, 공간적 특성을 반영한 요소가 브랜드 기준의 불일치로 판단되지 않도록 구성하였다. 이에 따라 브랜드 공통 기준에서 벗어나거나 브랜드 아이덴티티를 약화시키는 요소는 부적합 요소(mismatch elements)로 정합성 판단에 반영하되, 코드북에 정의된 지역 특화 요소(regional specifics)는 브랜드 기준과의 불일치에 따른 감점 대상으로 판단되지 않도록 평가 조건을 설정하였다. 이를 통해 브랜드별로 상이하게 서술된 정성적 디자인 정보를 동일한 평가 체계 안에서 적용 가능한 형태로 구조화하면서도, 개별 브랜드와 프로퍼티가 갖는 고유한 공간적 특성을 평가에 반영하고자 하였다.
Table 2.
Evaluation criteria of the brand codebook
3.3 공간 이미지 데이터셋 구축
본 연구의 평가대상은 호텔 브랜드 공간 아이덴티티가 구현된 실제 호텔 공간 이미지이다. 글로벌 호텔 산업 분석 보고서에서 제시한 주요 호텔 그룹(Samjong KPMG Economic Research Institute, 2025)과 브랜드 포트폴리오의 다양성, 위탁운영(Management Contract) 체계의 운영 특성을 고려하여 Marriott International, Hilton Worldwide, Hyatt Hotels Corporation 및 Lotte Hotels & Resorts의 4개 호텔 그룹에 속한 12개 브랜드, 50개 프로퍼티로 구성하였다(Table 3). 브랜드는 Luxury, Upper Upscale, Lifestyle, Business의 서로 다른 티어를 포함하였으며, 티어는 STR Chain Scale 분류와 각 그룹의 공식 브랜드 포트폴리오를 기준으로 구분하였다(STR, 2024). 연구의 지리적 범위는 아시아·태평양(Asia-Pacific) 지역으로 한정하였다. 글로벌 호텔 그룹은 전 세계에 다수의 프로퍼티를 운영하고 있어 전체를 연구대상에 포함하기 어려우며, 본 연구에는 국내 호텔 그룹인 Lotte Hotels & Resorts가 포함된 점을 고려하여 글로벌 브랜드와 국내 브랜드 간 비교 가능성을 확보하고 지역적 편차를 줄이기 위해 롯데호텔그룹이 실제 운영되는 아시아·태평양 권역을 공통 연구범위로 설정하였다.
Table 3.
Hotel brands and properties
평가 이미지는 프로퍼티당 10장을 기준으로 총 500장을 수집하였다. 공간 유형은 브랜드 아이덴티티가 비교적 명확하게 드러나고 브랜드 간 비교가 가능한 공간 중심으로 로비 5장, 복도·라운지 등 공용부 2장, F&B 공간 2장, 피트니스 등 부대시설 1장의 비율로 구성하였다. 객실은 브랜드 아이덴티티뿐만 아니라 객실 등급과 타입의 영향을 받을 수 있는 점을 고려하여 수집대상에서 제외하였다.
이미지는 출처에 따라 공식 홈페이지와 보도자료 등 운영사가 제공한 통제이미지(controlled)와 OTA 리뷰 플랫폼 및 웹 검색 등을 통해 확보한 비통제 이미지(uncontrolled)로 구분하여 수집하였다. 이를 통해 브랜드가 공식적으로 제시하는 공간 이미지와 실제 운영환경에서 나타나는 공간 이미지를 함께 데이터셋에 포함하였으며, 출처 유형 간 차이 자체는 독립적인 분석대상으로 설정하지 않고, 다양한 이미지 수집환경을 반영하기 위한 보조적 분류기준으로 활용하였다.
수집된 이미지에는 사전 필터링, 기술적 전처리, 연구자 검수의 3단계 전처리 과정을 적용하였다. 장변 1,000 px 미만의 저해상도 이미지, 역광·과노출 등으로 공간 식별이 어려운 이미지, 공사 또는 이벤트 연출이 포함된 이미지, 수집 시점을 기준으로 5년 이상 경과한 이미지를 제외하였다. 기술적 전처리에서는 색공간을 sRGB로 표준화하고 Gray World 알고리즘 기반의 화이트밸런스 보정을 적용하여 촬영환경에 따른 색 편차를 줄였다. 이후 연구자 검수를 통해 수집된 이미지 중 중복 이미지나 인물·사물 중심으로 촬영되어 공간 대표성이 부족한 이미지를 재검토하고 필요한 경우 대체 이미지를 수집하였다. 이 과정에서 화이트밸런스 보정은 일부 공간에서 의도적으로 연출된 조명의 색온도를 중성적으로 변화시킬 가능성이 있으며, 이에 따른 영향은 제 5장에서 연구의 한계로 논의한다. 총 500장의 이미지 데이터셋을 구축하였으며, 이후 VLM 평가 및 기술적 검토 과정에서 최종적으로 분석에 활용하기 어려운 3장을 제외하여 497장을 최종 분석대상으로 확정하였다. 각 이미지는 해당 브랜드의 코드북과 연계하여 평가할 수 있도록 브랜드, 티어, 프로퍼티, 공간 유형 및 출처 유형 등의 정보를 함께 관리하였다.
3.4 VLM 기반 공간 이미지 평가
본 연구에서는 텍스트로 구성된 브랜드 코드북과 공간 이미지를 함께 해석하기 위해 Vision-Language Model(VLM)을 평가 도구로 활용하였다. 2.3절에서 논의한 바와 같이 본 연구의 평가 기준은 보편적 시각 특성의 수치가 아닌 서술형으로 구조화된 브랜드별 디자인 기준이므로, 텍스트 기준과 이미지를 함께 입력받아 항목별 판단과 그 근거를 생성할 수 있는 VLM을 평가도구로 적용하였다. 평가에는 Claude (claude-sonnet-4-6; Anthropic, 2026)를 사용하였으며, 12개 브랜드와 497장의 전체 이미지 평가에 동일한 모델 버전을 적용하고 브랜드나 평가 시점에 따라 모델을 혼용하지 않았다.
평가 시에는 브랜드별 코드북(JSON)을 고정된 평가기준(reference)으로, 각 호텔 공간 이미지를 평가 대상(variable)으로 입력하여 이미지에 구현된 공간적 특성이 해당 브랜드의 디자인 기준에 어느 정도 부합하는지를 평가하도록 하였다. 모든 이미지에는 동일한 구조의 평가 프롬프트를 적용하였으며, 프롬프트는 ① 평가대상 브랜드의 코드북 기준 제시, ② 평가 이미지 입력, ③ 7개 평가항목별 1~10점의 정합성 점수와 판단 근거 산출, ④ 코드북에 정의된 지역 특화 요소를 브랜드 불일치에 따른 감점 대상으로 판단하지 않도록 하는 지시로 구성하였다. 각 이미지는 소속 브랜드의 코드북만을 참조하여 독립적으로 평가하였으며, 다른 브랜드의 코드북이나 평가 결과와의 교차 비교는 수행하지 않았다. 즉, 브랜드 간 상대적 우위를 평가하는 것이 아니라 각 공간 이미지가 해당 브랜드에 대해 사전에 정의된 코드북 기준을 어느 정도 충족하는지를 개별적으로 평가하도록 설계하였다.
VLM의 평가 결과는 7개 항목별 점수와 판단 근거를 구조화된 형식으로 저장하였으며, 추후 유형별 분석을 위해 브랜드, 티어, 프로퍼티, 공간유형, 출처 유형, 모델 및 코드북 버전 등의 메타데이터와 함께 관리하였다. 평가 완료 후 출력형식, 평가 항목 누락 및 이미지와 코드북의 연결 여부 등 기술적 오류를 점검하였으며, 오류가 확인된 경우에 한하여 동일한 조건으로 재평가를 진행하였다. 모든 평가에는 동일한 모델 버전, 프롬프트 구조 및 브랜드별 코드북을 적용하여 평가 조건의 일관성을 유지하였으며 최종 결과는 제 4장의 분석과 HITL 전문가 검증에 활용하였다.
3.5 HITL 기반 평가 검증
VLM 기반 평가 결과를 전문가 판단과 비교하기 위해 Human-in-the-Loop (HITL) 방식의 전문가 검증을 수행하였다. 전체 497장의 평가 이미지 중 AI 평가점수의 분포와 브랜드, 티어 및 공간 유형의 다양성을 고려하여 24장의 대표 이미지를 선정하였다. AI 평가점수는 고점(8점 이상), 중점(5점 초과~7점 이하), 저점(5점 이하) 구간을 고려하여 구성함으로써 특정 점수대에 검증 이미지가 편중되지 않도록 하였다.
전문가 패널은 호텔 브랜드 공간 관련 실무 전문가 30명으로 구성하였으며, 실내·공간디자인 및 FF&E 18명, TS 및 개발 7명, 브랜드 기획·관리 5명으로 구성되었다. 이 중 22명(73.3%)이 관련 분야 7년 이상의 경력을 보유하였다(Table 4).
Table 4.
Composition of HITL expert panel
| Field | n | % | ≥7 years |
| Interior/Spatial Design & FF&E | 18 | 60.0 | 13 |
| TS & Development | 7 | 23.3 | 6 |
| Brand Planning & Management | 5 | 16.7 | 3 |
| Total | 30 | 100.0 | 22 (73.3%) |
전문가 평가는 온라인 설문으로 진행하였으며, AI 평가와 동일한 7개 평가항목과 1~10점 척도로 각 이미지를 독립적으로 평가하였다. 각 이미지의 평가 화면에는 해당 브랜드의 코드북 핵심 기준을 함께 제시하여, 전문가 역시 AI와 동일한 기준을 참조하여 판단하도록 하였다. 이는 서로 다른 평가기준의 적용으로 발생할 수 있는 차이를 줄이고, 동일한 기준 아래에서 도출된 AI와 전문가의 판단을 비교하기 위한 것이다.
AI와 전문가 평가는 이미지별 AI점수와 전문가 30명의 평균점수를 비교하였으며, 종합 브랜드 아이덴티티 정합성을 중심으로 7개 평가항목별 분석을 병행하였다. 두 평가 간 관계는 Pearson 상관계수(r)와 Spearman 순위상관계수(ρ)를 주요 지표로 분석하고, 절대적인 점수 일치 수준은 Cohen의 가중 카파(weighted κ)를 보조지표로 활용하였다(Cohen, 1968). 또한 AI와 전문가 평균점수의 차이를 통해 관대성 편향(leniency bias)을, 평균절대오차(Mean Absolute Error, MAE)를 통해 점수 차이의 크기를 분석하였다. 이와 함께 5.5점을 기준으로 각 이미지를 고·저로 구분하여 두 평가의 분류가 일치하는 비율을 방향 일치율로 산출하였다. 모든 통계 분석은 Python 환경에서 수행하였으며, 통계적 유의수준은 p<.05로 설정하였다. 이를 통해 AI와 전문가 평가 간의 관계와 차이를 함께 분석하여 VLM 기반 평가의 보조도구로서 적용 가능성과 한계를 검토하였다.
4. 분석결과
4.1 AI 기반 브랜드 공간 정합성 평가 결과
최종 497장의 공간 이미지를 대상으로 VLM 기반 브랜드 공간 정합성 평가를 수행한 결과, 종합 브랜드 아이덴티티 정합성의 전체 평균은 7.312점(SD=1.773)으로 나타났다. 각 이미지는 3.4절에서 제시한 바와 같이 소속 브랜드의 코드북을 고정된 평가기준으로 적용하여 독립적으로 평가되었다. 따라서 이하의 브랜드, 그룹 및 티어별 점수는 브랜드 간 우열이 아니라, 각 브랜드의 공간 이미지가 해당 브랜드에 정의된 디자인 기준에 부합하는 정도의 차이를 나타낸다.
브랜드별 종합 정합성 평균은 Conrad가 8.590점으로 가장 높았으며, Park Hyatt 8.450점, Lotte City Hotel 8.143점, Grand Hyatt 8.025점 순으로 나타났다. 반면 L7은 5.974점으로 가장 낮았으며, 최고·최저 브랜드 간에는 2.62점의 차이가 나타났다(Table 5). 브랜드 간 차이의 효과크기는 η²=.130으로, 동일한 평가절차를 적용하였을 때 코드북 기준에 대한 공간 이미지 정합성 수준이 브랜드별로 서로 다르게 나타남을 확인하였다.
Table 5.
Mean AI scores by brand and evaluation criterion (n=497)
다만 브랜드별로 서로 다른 내용의 코드북이 적용되었으며, 공개자료의 범위와 구체성에도 차이가 있으므로 브랜드별 평균점수에는 공간 이미지의 정합성뿐 아니라 코드북의 내용과 기술 범위가 함께 영향을 미쳤을 가능성이 있다. 따라서 브랜드별 점수는 각 브랜드의 코드북을 기준으로 산출된 결과로 해석하며, 브랜드 간 평균점수 차이를 브랜드 간 우열이나 VLM의 정합성 판별 성능을 직접적으로 나타내는 결과로 해석하지 않는다.
그룹별 평균은 Hyatt 8.238점, Hilton 7.613점, Lotte 7.374점, Marriott 6.294점으로 나타났으며, 티어별 평균은 Business 8.143점, Luxury 7.463점, Upper Upscale 7.082점, Lifestyle 5.974점으로 나타났다. 다만 티어별 포함된 브랜드 수와 표본 구성이 다르며, 특히 Business와 Lifestyle 티어는 각각 단일 브랜드(Lotte City Hotel, L7)로 구성되어 있다. 따라서 티어별 결과는 해당 티어 자체의 일반적인 특성이 아니라 본 연구대상 안에서 나타난 상대적 결과로 해석할 필요가 있다.
평가 항목별로 평균은 소재·마감 정합성이 7.861점으로 가장 높았으며, 공간 분위기 정합성 7.582점, 색채 정합성 7.332점, 브랜드 톤앤매너 정합성 7.330점, 공간 유형 적합성 7.314점, 종합 브랜드 아이덴티티 정합성 7.312점 순으로 나타났다. 반면 현지화·지역성은 6.879점으로 가장 낮게 나타났다. 브랜드별 평가항목에서도 동일한 수준의 점수가 일률적으로 나타나기보다 각 브랜드에 따라 상대적으로 높은 항목과 낮은 항목이 구분되었다(Table 5). 특히 현지화·지역성은 브랜드별 편차가 나타난 항목으로, 해당 항목에 대한 AI와 전문가 판단의 관계는 4.2절 전문가 비교에서 추가적으로 검토하였다.
4.2 AI–전문가 평가 비교 및 검증
검증 이미지 24장에 대한 종합 브랜드 아이덴티티 정합성의 평균은 AI 7.333점, 전문가 6.505점으로 나타났다. AI가 전문가보다 평균 0.828점 높게 평가하는 관대성 편향(leniency bias)이 확인되었으며(Table 6), 편향의 크기는 색채 정합성에서 +0.42점으로 가장 작고, 현지화·지역성에서 +1.51점으로 가장 크게 나타났다. 색채 정합성과 같이 시각적으로 명확한 요소에서는 AI와 전문가 간 차이가 상대적으로 작게 나타난 반면, 문화적, 지역적 맥락의 해석이 요구되는 현지화·지역성에서는 가장 차이가 컸다.
Table 6.
Comparison of AI and expert scores by evaluation criterion (n=24)
두 평가 간 관계를 분석한 결과, 종합 브랜드 아이덴티티 정합성에서 Pearson 상관계수는 r=0.436(p=.033), Spearman 순위상관계수는 ρ=0.464(p=.014)로 모두 통계적으로 유의한 정적 상관을 나타냈다(Table 7). 이는 AI가 상대적으로 높게 평가한 이미지는 전문가도 높게, 낮게 평가한 이미지는 전문가도 낮게 평가하는 경향이 있음을 의미한다. 또한 5.5점을 기준으로 각 이미지를 고·저로 구분하였을 때 24장 중 17장(70.8%)에서 AI와 전문가의 분류가 일치하였다.
Table 7.
Agreement between AI and expert evaluations on overall identity coherence (n=24)
반면 절대적인 점수 수준의 일치도에서는 차이가 나타났다. 평균절대오차(MAE)는 1.733점, Cohen의 이차 가중 카파는 κ=.187로 나타났으며, κ는 Landis and Koch (1977)의 기준에서 매우 낮은 일치(slight agreement)에 해당하였다. 다만 AI는 이미지마다 5점, 7점, 10점 등 정수 점수를 산출한 반면, 전문가 점수는 30명의 평가를 평균한 연속적인 값이었다. 이러한 두 평가의 점수 산출구조에 차이가 발생한다. 이에 따라 본 연구에서는 Pearson 및 Spearman 상관계수를 주요 지표로 활용하고, weighted κ는 절대적인 점수 일치 수준을 확인하는 보조지표로 해석하였다.
평가항목별로는 현지화·지역성을 제외한 6개 항목에서 유의한 정적 상관(r=0.419~0.459, p<.05)이 확인되었다. 특히 이 가운데 공간 유형 적합성(r=0.459)과 브랜드 톤앤매너 정합성(r=0.457)이 상대적으로 높은 상관을 보였다. 반면 현지화·지역성은 r=-0.161(p=.453)로 유의한 상관이 나타나지 않았으며, 7개 항목 중 유일하게 음의 상관을 보였다. 또한 AI와 전문가 간 평균점수 차이도 +1.51점으로 가장 크게 나타나, 다른 평가항목에 비해 AI와 전문가 간 평가 차이가 큰 항목으로 확인되었다. 현지화·지역성은 색채나 소재·마감과 같이 이미지에서 비교적 직접적으로 관찰할 수 있는 시각적 요소와 달리, 지역적 요소와 문화적 맥락의 관계를 함께 판단해야 하는 항목이라는 점에서 이러한 특성이 AI와 전문가 간 평가 차이와 관련되었을 가능성이 있다.
종합하면, AI 평가는 전문가와 절대적인 점수 수준에서는 차이를 보였으나, 이미지 간 상대적인 정합성 수준에서는 유의한 관계를 보였으며, 고·저 분류에서도 70.8%가 일치하였다. 반면, 현지화·지역성과 같이 문화적·지역적 맥락의 해석이 요구되는 항목에서는 전문가 판단과 차이가 나타나, 평가항목의 특성에 따라 VLM 기반 평가의 적용 범위에 차이가 있음을 확인하였다. 다만 이러한 결과는 단일 VLM과 브랜드 코드북을 적용하고 선정된 24장의 이미지를 대상으로 전문가 검증을 수행한 본 연구의 조건에서 확인된 결과이다. 따라서 이를 VLM의 일반적인 평가 성능으로 확대 해석하기보다는 제안한 평가 방법의 적용가능성과 한계를 확인한 결과로 해석할 필요가 있다.
4.3 AI–전문가 판단 불일치 사례 분석
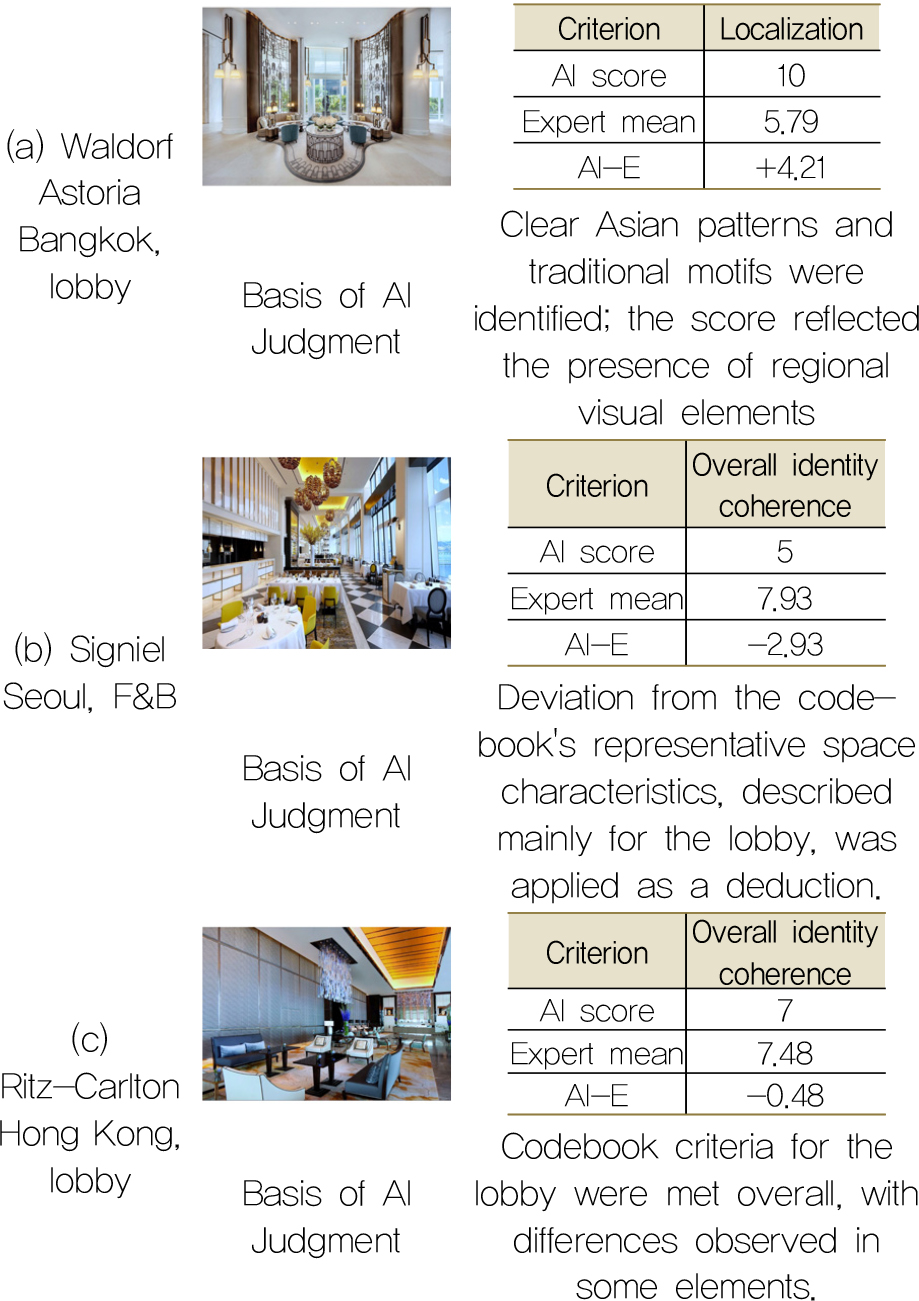
4.2절의 정량적 비교 결과를 구체적으로 검토하기 위해, 검증 이미지 24장 가운데 AI와 전문가 간 판단 차이가 두드러진 사례와 가장 근접한 사례를 선정하여 VLM이 제시한 판단 근거와 함께 분석하였다(Figure 3). 전문가 평가는 항목별 정량적 점수를 중심으로 수집하였으며, 개별 이미지에 대한 서술형 판단 근거는 별도로 수집하지 않았다. 따라서 이하에서 제시하는 전문가 판단에 관한 설명은 전문가가 직접 제시한 평가 이유가 아니라, 평가점수와 이미지 및 코드북의 특성을 바탕으로 연구자가 제시한 가능한 해석이다. 또한 사례에 제시된 AI의 판단 근거는 VLM이 평가점수와 함께 생성한 텍스트 설명으로, 모델의 내부 판단과정을 직접적으로 나타내는 것은 아니며 사례별 평가 차이를 해석하기 위한 참고자료로 활용하였다.
사례 분석에 앞서, 평가 후 전문가들에게 AI가 평가하기 어렵다고 생각하는 항목을 조사한 결과(Table 8), 현지화·지역성이 65.5%(19/29명)로 가장 높게 나타났다. 다음으로 브랜드 톤앤매너와 종합 브랜드 아이덴티티 정합성이 각각 48.3%, 공간 분위기가 44.8%로 나타났다. 이는 전문가들이 현지화·지역성을 AI가 판단하기 어려운 항목으로 인식하고 있음을 보여준다.
Table 8.
Expert perception of AI evaluation difficulty by criterion
첫 번째는 현지화·지역성 항목에서 가장 큰 차이를 보인 Waldorf Astoria Bangkok 로비 사례이다(Figure 3a). AI는 아시아적 문양과 전통 모티프 등 지역적 시각 요소가 명확하게 나타난다는 근거로 10점을 부여한 반면, 전문가 평균은 5.79점으로 4.21점의 차이가 나타났다. AI의 판단은 지역적 시각 요소의 존재 여부에 상대적으로 높은 비중을 둔 것으로 나타난 반면, 전문가 평가에는 이러한 요소가 브랜드 아이덴티티와 문화적으로 어떻게 통합되는지가 함께 고려되었을 가능성이 있다. 이는 현지화·지역성이 AI가 평가하기 어려운 항목으로 가장 많이 선택된 Table 8의 결과, 그리고 AI와 전문가 간 유의한 상관이 나타나지 않고(r=−.161, p=.453) 평균점수 차이도 가장 크게 나타난 4.2절의 결과(+1.51점)와도 연결된다.
두 번째는 전체적인 관대성 편향과 달리 AI가 전문가보다 낮게 평가한 Signiel Seoul F&B 사례이다(Figure 3b). 종합 브랜드 아이덴티티 정합성에서 AI는 5점을 부여한 반면 전문가 평균은 7.93점으로 나타났다. AI의 판단 근거에서는 코드북에 기술된 대표 공간 특성과의 차이가 주요 감점요인으로 반영된 반면, 전문가 평가에는 F&B 공간의 조명 연출과 공간 구성 등 해당 공간 유형의 특성이 함께 반영되었을 가능성이 있다. 검증 이미지 중 로비(n=17)에서는 AI와 전문가 간 r=.642의 정적 상관이 나타난 반면, F&B(n=5)에서는 r=-.891의 역상관이 관찰되었다. 다만 F&B의 표본이 5장으로 제한되어 있어 일반화에는 한계가 있으며, 이 사례는 코드북에 충분히 기술되지 않은 공간 유형에서 평가 차이가 발생 가능한 사례로 해석할 수 있다.
세 번째는 AI와 전문가 평가가 가장 근접한 Ritz-Carlton Hong Kong 로비 사례이다(Figure 3c). 종합 브랜드 아이덴티티 정합성은 AI 7점, 전문가 평균 7.48점으로 0.48점의 차이를 보였다. 해당 이미지는 코드북에 주요 공간 특성이 비교적 명확하게 정의된 로비 공간으로, AI와 전문가 모두 코드북 기준을 대체로 충족하되 일부 요소에는 차이가 있는 것으로 판단하였다. 이는 평가 기준이 명확하게 정의된 공간 유형에서는, AI와 전문가의 판단이 근접하게 나타날 수 있음을 보여준다.
세 사례를 종합하면, 현지화·지역성과 같이 맥락적인 판단이 필요한 항목이나 코드북에 해당 공간의 특성이 충분히 제시되지 않은 경우 AI와 전문가의 평가 차이가 나타날 가능성이 있었다. 반면 코드북의 평가기준과 공간 유형이 비교적 명확한 사례에서는 두 평가가 근접하게 나타났다. 다만 전문가의 이미지별 판단 이유를 직접 수집하지 않았으므로, 이러한 결과는 평가 차이가 발생한 원인을 확정하기보다는 가능한 원인을 살펴본 사례분석으로 해석할 필요가 있다.
5. 결 론
5.1 연구결과 및 의의
본 연구는 위탁운영 호텔 환경에서 정성적으로 해석·평가되어 온 브랜드 공간 디자인을 대상으로, 브랜드 공간 아이덴티티의 정합성을 동일한 기준으로 진단할 수 있는 AI 기반 보조 평가 방법을 제안하고, 그 적용 가능성과 한계를 Human-in-the-Loop(HITL) 전문가 검증을 통해 확인하는 것을 목적으로 수행되었다. 이를 위해 호텔 브랜드의 공간 아이덴티티를 구성하는 정성적 디자인 기준을 브랜드별 코드북으로 구조화하여 고정된 평가기준(Reference)으로 설정하고, 실제 공간 이미지를 평가대상(Variable)으로 설정하여 Vision-Language Model (VLM)이 코드북 기준과의 정합성을 평가하는 체계를 구성하였다. 국내외 4개 호텔 그룹의 12개 브랜드, 50개 프로퍼티에서 수집한 최종 497장의 공간 이미지를 대상으로 AI 평가를 수행하였으며, 이 중 브랜드와 공간 유형, 점수 분포를 고려하여 24장을 선정 후, 호텔 분야 실무 전문가 30명의 평가결과와 비교·분석하였다.
분석 결과, 종합 브랜드 아이덴티티 정합성에서 AI와 전문가 평가는 유의한 정적 상관을 나타냈으며(Pearson r=.436, p=.033; Spearman ρ=.464, p=.014), 두 평가가 상대적인 평가 경향에서 일정한 관계를 보였다. 반면 평가점수 자체의 일치 수준은 낮았으며(weighted κ=.187), AI는 전문가보다 평균 0.828점 높게 평가하는 경향을 보여 상대적인 평가 경향과 실제 점수 수준의 일치는 구분하여 해석할 필요가 있음을 확인하였다.
평가항목별로는 현지화·지역성을 제외한 6개 항목에서 유의한 정적 상관(r=.419~.459, p<.05)이 확인된 반면, 현지화·지역성에서는 유의한 상관이 나타나지 않았으며(r=-.161, p=.453), AI가 전문가보다 평균 1.51점 높게 평가하였다. 현지화·지역성이 이미지에서 관찰되는 시각적 요소뿐 아니라 문화적 맥락과 지역적 특성을 함께 판단해야 하는 항목이라 이에 대한 AI 평가의 한계를 확인할 수 있었다. 다만 전문가의 개별 판단 근거를 직접 수집하지 않았으므로 이러한 설명은 가능한 해석으로 한정하였다. 종합하면, 본 연구에서 제안한 방법은 구조화된 브랜드 코드북을 기준으로 다수의 공간 이미지를 반복적으로 평가하고 우선 검토 대상을 선별하는 1차 스크리닝 및 의사결정 지원도구로 활용할 수 있는 가능성을 보여준다. 다만 절대적인 점수와 맥락 의존적 항목에서는 전문가 평가와 차이가 확인된 만큼, AI를 전문가의 대체수단으로 활용하기보다는 초기 진단에는 AI를 활용하고 주요 판단과 최종 의사결정에는 전문가 검토를 병행하는 HITL 방식으로 활용하는 것이 적절하다.
5.1.1 학술적 의의
첫째, 본 연구는 수치나 명확한 규칙만으로 정의하기 어려운 공간 디자인의 정성적 판단기준을 구조화하여 반복적으로 적용할 수 있는 평가 체계로 전환하였다. 기존 BIM 기반 설계 정보 평가에서는 인증기준 등의 평가 조건을 구조화하여 설계정보와 비교함으로써 기준의 충족 여부를 검토하는 방법이 제안되어 왔다. 본 연구는 이러한 기준 기반의 정량적 평가 관점에서 정성적 디자인 영역으로 확장하여, 브랜드 아이덴티티를 구성하는 디자인 요소와 판단기준을 구조화하고 이를 브랜드 코드북으로 구축하여 실제 공간 이미지 평가에 적용하였다. 이는 비정형적인 디자인 정보를 AI가 참조할 수 있는 구조화된 평가 기준으로 활용하였다는 점에서 의의가 있다.
둘째, 본 연구는 AI와 전문가에게 동일한 평가 기준과 척도를 적용한 HITL 검증을 통해 VLM 기반 정성적 평가의 적용 가능성과 한계를 함께 확인하였다. AI와 전문가 평가 간에는 유의한 정적 상관이 확인된 반면 절대적인 점수 수준과 현지화·지역성과 같은 맥락 의존적 항목에서는 차이가 나타났다. 이는 AI 평가가 적용될 수 있는 영역과 전문가의 맥락적 판단이 필요한 영역을 함께 확인한 것으로, AI를 전문가 판단의 대체수단이 아닌 보조적 평가방법으로 활용하기 위한 근거를 제시하였다는 점에서 의미가 있다.
5.1.2 실무적 의의
첫째, 본 연구에서 제안한 방법은 다수의 프로퍼티를 보유한 브랜드 운영사의 TS (Technical Services)에서 현장 점검의 우선순위를 설정하는 사전 스크리닝 도구로 활용될 수 있다. 특히 호텔과 같은 위탁운영 환경에서는 제한된 인력과 시간으로 다수의 프로퍼티를 검토해야 하며, 정성적 공간 디자인에 대한 판단은 담당자의 경험과 해석에 따라 차이가 발생할 수 있다. 이때 구조화된 브랜드 코드북을 기준으로 다수의 공간 이미지를 동일한 절차로 반복 평가함으로써 상대적인 정합성 수준을 파악하고, 추가적인 검토가 필요한 대상을 우선적으로 선별할 수 있다.
둘째, AI 평가점수는 전문가 평가와 동일한 절대적 판정값보다 상대적인 정합성 수준을 파악하기 위한 보조지표로 활용하는 것이 적절하다. 본 연구에서 AI는 전문가보다 평균 0.828점 높게 평가하는 경향을 보였으며, 절대적인 점수의 일치 수준도 낮게 나타났다. 특히 위탁운영 환경에서는 계약 및 개관 전 검수 과정에서 제한된 이미지와 정보만으로 실제 구현 수준을 충분히 판단하기 어려울 수 있으므로, AI 평가 결과를 단독으로 적용하는 데에는 한계가 있다. 따라서 평가점수만으로 승인 여부를 판단하기보다는 동일한 브랜드 기준에서 상대적으로 정합성이 낮거나 추가 검토가 필요한 공간을 선별하는 방식으로 활용할 필요가 있다.
셋째, AI 기반 평가는 전문가를 대체하는 도구가 아니라, 초기 진단과 사전 검토과정에서 의사결정을 지원하는 보조 평가 도구로서 활용 가능성을 확인하였다. 본 연구에서도 현지화·지역성과 같이 문화적·지역적 맥락의 해석이 필요한 항목에서는 AI와 전문가 평가 간 차이가 확인되었다. 따라서 초기 단계에서는 AI를 활용하여 다수의 공간을 동일한 기준으로 빠르게 검토하고, 실제 구현 수준의 확인이나 계약 검수 및 개관 승인과 같은 주요 의사결정 단계에서는 현장 확인과 전문가 검토를 병행하는 HITL 방식으로 활용하는 것이 적절하다.
종합하면, 본 연구에서 제안한 AI 기반 보조 평가 방법은 구조화된 브랜드 코드북을 기준으로 다수의 공간 이미지를 반복적이고 일관된 절차로 평가하고, 전문가 평가와 일정한 상대적 관계를 나타냄으로써 브랜드 공간 정합성의 사전 진단과 우선 검토 대상 선별을 위한 보조도구로서의 적용 가능성을 보여주었다. 반면 절대적인 점수 수준과 현지화·지역성과 같은 맥락 의존적 항목에서는 AI와 전문가 간 차이가 확인되었다. 따라서 AI 평가를 전문가 판단과 동일한 절대적 판정값으로 활용하기보다는, 위탁운영 구조나 프랜차이즈 등 다수 프로퍼티를 대상으로 상대적인 정합성 수준을 파악하고 우선 검토 대상을 선별하는 1차 스크리닝 및 의사결정 지원도구로 활용하며, 맥락적 판단과 최종 의사결정 단계에서는 전문가 검토를 병행하는 HITL 방식으로 활용하는 것이 적절하다.
5.2 연구한계 및 향후 연구
본 연구는 정성적 공간 디자인 기준을 구조화하고 VLM을 활용하여 실제 공간 이미지의 정합성을 평가하는 방법을 제안하였으나, 다음과 같은 한계가 있다.
첫째, 브랜드 코드북의 구축범위와 입력방식에 한계가 있다. 본 연구의 브랜드 코드북은 브랜드 공식 홈페이지, 공식 보도자료 및 전문매체 등 온라인에서 접근 가능한 공개자료를 기반으로 구축하였다. 실제 브랜드 운영 및 설계 과정에서 활용되는 내부 디자인 가이드의 세부 기준을 모두 반영하는 데에는 한계가 있으며, 브랜드와 공간 유형에 따라 공개된 정보의 범위와 구체성에도 차이가 존재한다. 또한, 코드북의 대표 공간 특성이 주로 로비를 중심으로 기술되어 F&B 등 다른 공간 유형에 대한 기준이 상대적으로 제한적이었으며, 현지화·지역성 항목은 지역 특화 요소를 감점에서 제외하도록 설계하였음에도 AI와 전문가 간 차이가 가장 크게 나타났다. 또한 평가 시에는 평가 기준 항목 외의 배경 참고 정보를 포함한 코드북 전체가 입력되었다. 향후에는 공간 유형별 코드북을 구성하고, 지역적 요소와 브랜드 아이덴티티의 조화를 판단하는 기준을 구체화하며, 평가 기준의 입력 범위를 분리하여 그 영향을 검토할 필요가 있다.
둘째, AI와 전문가의 점수 산출 구조가 서로 다르다. AI는 5점, 7점, 10점 등 특정 정수 형태의 점수에 집중된 평가를 수행한 반면, 전문가 점수는 30명의 평균값으로 산출되어, 절대적 일치도 지표가 낮게 나타났을 가능성이 있다. 또한 AI 평가에서는 전문가보다 높은 점수를 부여하는 관대성 편향이 확인되었다. 향후에는 0.5점 단위 등 보다 세분화된 척도를 사용하고, 편향을 함께 보정하는 방법도 검토할 필요가 있다.
셋째, 전문가 검증의 규모가 제한적이다. HITL 검증은 전체 497장 이미지 중 선정된 24장의 대표 이미지를 대상으로 호텔 실무 전문가 30명이 참여하여 수행되었다. 또한 7개 평가항목별 상관분석은 여러 항목을 동시에 검정함에 따라 우연히 유의한 결과가 나타날 가능성(다중비교 문제)을 보정하지 않았으므로, 항목별 결과는 전반적인 경향을 확인하는 참고 수준으로 해석할 필요가 있다. 공간 유형별 비교 역시 F&B, 피트니스, 공용부의 표본 수가 제한적이므로 일반화에 주의가 필요하다. 향후에는 검증 표본을 확대하여 항목별·공간 유형별 결과를 추가로 검증할 필요가 있다.
넷째, 평가모델과 결과 안정성에 대한 검증 범위가 제한적이다. 본 연구의 평가 절차는 코드북(JSON)과 표준화된 프롬프트 구조로 구성되어 다른 VLM에도 적용할 수 있도록 설계되었으나, 실제 평가는 조건의 일관성을 유지하기 위해 단일 VLM (Claude Sonnet 4.6)으로 1회씩 수행되었으므로, 절차가 특정 모델에 의존하지 않는다는 점과 반복 평가의 일관성을 확인하지 못하였다. 따라서 본 연구의 결과는 해당 모델과 평가 조건에서 확인된 것으로 해석할 필요가 있다. 향후에는 동일한 코드북과 평가절차를 복수의 VLM에 적용하고 반복 평가를 수행하여 모델별 평가 결과의 차이와, 단일 평가 및 반복 평가에 따른 일관성을 비교함으로써, 제안 연구 프레임의 모델 간 적용 가능성과 재현성을 확인할 필요가 있다.
다섯째, 연구 대상과 이미지 데이터의 범위에 한계가 있다. 본 연구는 아시아·태평양 권역의 12개 호텔 브랜드와 50개 프로퍼티를 대상으로 하였으며, 평가 데이터는 온라인에서 수집한 공간 이미지로 구성하였다. 또한 이미지 전처리 과정에서 적용한 화이트밸런스 보정은 이미지 간 색 편차를 줄이기 위한 표준화 과정이었으나, 일부 공간에서 의도적으로 연출된 조명의 색온도에 영향을 미쳤을 가능성이 있다. 따라서 본 연구의 결과를 다른 지역이나, 다양한 공간 유형 및 이미지 조건에 일반화하는 데에는 한계가 있다. 향후에는 동일한 호텔 브랜드의 다른 권역 프로퍼티와 현장 촬영 이미지를 포함하여 데이터 범위를 확대하고, 조명과 색온도의 특성을 보다 충실히 보존할 수 있는 전처리 기법을 검토할 필요가 있다. 나아가 리테일 매장이나 프랜차이즈 상업시설과 같이 공통된 디자인 기준이나 매뉴얼을 다수의 공간에 동일하게 적용하는 다른 유형의 공간을 대상으로 제안 방법의 적용 가능성을 검증할 필요가 있다.
아울러 본 연구는 BIM 모델을 직접 활용하지 않았으나, 건축·공간 분야에서 정성적 디자인 기준을 구조화된 평가기준으로 전환하고, 이를 실제 공간의 시각 정보와 비교하는 접근은 향후 BIM의 공간, 객체, 재료 및 마감 등의 속성정보와 연계하여 확장할 수 있다. 이를 통해 설계 단계에서 정의된 디자인 기준과 실제 구현공간의 평가 결과와 연계하고, 공간 디자인 기준의 관리와 검토를 지원하는 데이터 기반 방법으로 발전할 가능성을 검토할 수 있을 것이다.